Dlaczego pthread_mutex_lock zwykle nie robi syscalla
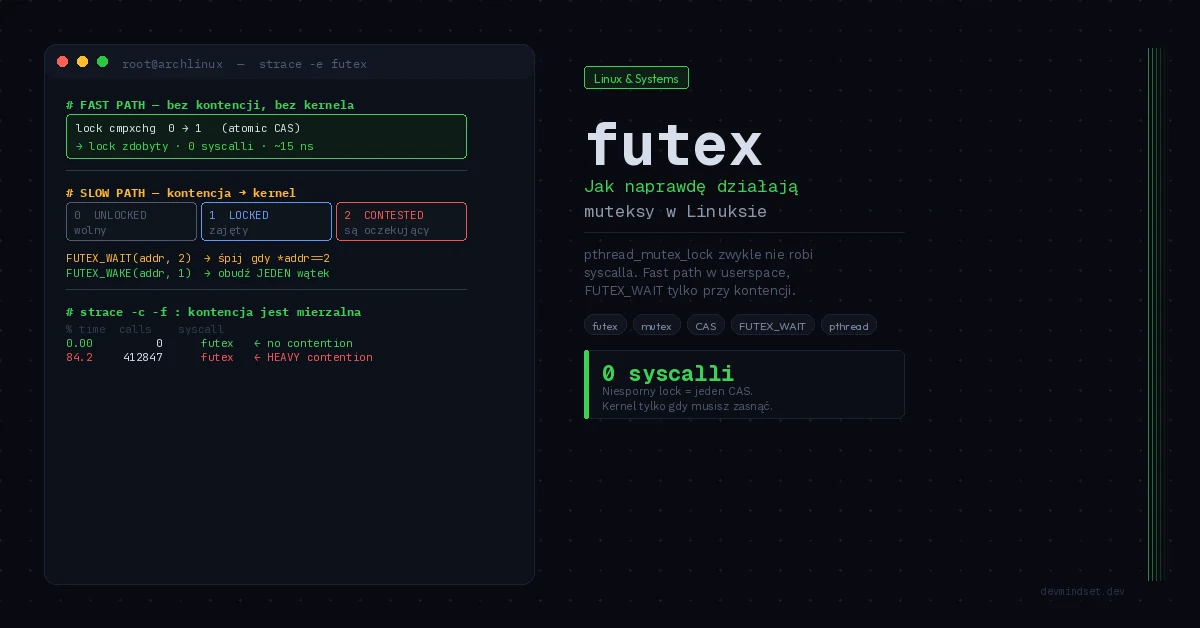
Powszechna intuicja: założenie muteksa to wejście do kernela. pthread_mutex_lock() wygląda jak operacja systemowa, więc „pewnie robi syscall”. Tymczasem w niespornym przypadku — gdy lock jest wolny i nikt o niego nie konkuruje — pthread_mutex_lock() nie dotyka kernela ani razu. Cała operacja to atomowa instrukcja CPU w userspace, której koszt zależy m.in. od CPU i stanu cache.
Sekretem jest futex (fast userspace mutex) — prymityw synchronizacji, na którym glibc buduje muteksy, zmienne warunkowe, semafory i bariery. Idea jest genialnie prosta: nie wołaj kernela, dopóki nie musisz. Dopóki nie ma kontencji, synchronizacja żyje w całości w userspace. Dopiero gdy wątek musi zasnąć czekając na lock, następuje syscall futex().
Ten artykuł rozkłada futex na fast path i slow path: atomowy CAS w userspace, mechanikę FUTEX_WAIT/FUTEX_WAKE, problem thundering herd, futeksy międzyprocesowe oraz — kluczowe dla decyzji produkcyjnych — kiedy narzut syscalla synchronizacji faktycznie się liczy.
Problem: dlaczego nie wystarczy zwykła zmienna
Najprostszy „lock” to flaga w pamięci: 0 = wolny, 1 = zajęty. Problem w tym, że sprawdzenie i ustawienie flagi to dwie osobne operacje, a między nimi inny wątek może wcisnąć się i też ustawić flagę — klasyczny race condition. Potrzebna jest operacja atomowa: sprawdź-i-ustaw w jednej, niepodzielnej instrukcji.
Fragment ze spinlockiem używa instrukcji PAUSE dla x86. Obiekt blokady trzeba zainicjalizować wartością zero przed udostępnieniem go wątkom.
Procesory dostarczają to przez instrukcje typu compare-and-swap (CAS). Na x86-64 to lock cmpxchg — porównuje wartość w pamięci z oczekiwaną i, jeśli pasuje, atomowo podmienia ją na nową. Prefiks lock gwarantuje, że żaden inny rdzeń nie wejdzie w trakcie operacji.
#include <stdatomic.h>

/* Najprostszy spinlock — CAS w pętli, bez kernela */
typedef struct {
    atomic_int locked;   /* 0 = wolny, 1 = zajęty */
} spinlock_t;

void spin_lock(spinlock_t *lock) {
    int expected = 0;
    /* Próbuj atomowo zmienić 0 → 1. Jeśli się nie uda, kręć w pętli. */
    while (!atomic_compare_exchange_weak(&lock->locked, &expected, 1)) {
        expected = 0;        /* CAS nadpisuje expected — resetuj */
        __builtin_ia32_pause();  /* instrukcja PAUSE — hint dla CPU */
    }
}

void spin_unlock(spinlock_t *lock) {
    atomic_store(&lock->locked, 0);
}
Spinlock działa, ale ma fatalną wadę: wątek czekający na lock spala CPU w pętli. Dla locka trzymanego mikrosekundy to akceptowalne. Dla locka trzymanego milisekundy — katastrofa: rdzeń kręci się jałowo zamiast oddać czas innym wątkom. Tu wchodzi futex.
Fast path: futex nie dotyka kernela
Kluczowa obserwacja stojąca za futeksem: w niespornym przypadku spinlock jest idealny — jeden CAS i gotowe, zero syscalli. Problem pojawia się dopiero przy kontencji, gdy wątek musi czekać. Futex łączy oba światy: fast path w userspace dla przypadku bez kontencji, slow path z syscallem tylko gdy trzeba zasnąć.
#define _GNU_SOURCE
#include <linux/futex.h>
#include <sys/syscall.h>
#include <unistd.h>
#include <stdatomic.h>
#include <errno.h>
#include <stdlib.h>

/* Model demonstracyjny: Linux, 32-bitowy lock-free atomic_int.
   Przed użyciem: atomic_int m = ATOMIC_VAR_INIT(0); */
_Static_assert(sizeof(atomic_int) == 4, "futex wymaga 4 bajtow");
_Static_assert(ATOMIC_INT_LOCK_FREE == 2, "wymagane atomiki lock-free");

static void wait_contested(atomic_int *m) {
    if (syscall(SYS_futex, m, FUTEX_WAIT, 2, NULL, NULL, 0) == -1
        && errno != EAGAIN && errno != EINTR) abort();
}

void futex_lock(atomic_int *m) {
    int expected = 0;
    if (atomic_compare_exchange_strong(m, &expected, 1)) return;
    /* exchange zwraca POPRZEDNI stan; CAS w C zwraca bool. */
    while (atomic_exchange(m, 2) != 0) {
        wait_contested(m);
        /* Po obudzeniu lub EINTR/EAGAIN zawsze sprawdzamy stan. */
    }
}

void futex_unlock(atomic_int *m) {
    if (atomic_exchange(m, 0) == 2) {
        if (syscall(SYS_futex, m, FUTEX_WAKE, 1, NULL, NULL, 0) == -1)
            abort();
    }
}
Stan 0 oznacza wolny mutex, 1 — zajęty bez oznaczonej kontencji, a 2 — zajęty i możliwych oczekujących. Dwójka nie jest licznikiem śpiących wątków. Kod demonstruje protokół WAIT/WAKE; nie obsługuje m.in. rekursji, śmierci właściciela ani dziedziczenia priorytetów. W aplikacji zwykle wybierzesz pthread_mutex_t.
Mechanika FUTEX_WAIT i FUTEX_WAKE
Dwie operacje stanowią rdzeń interfejsu, a ich semantyka jest precyzyjnie zaprojektowana wokół jednego problemu: wyścigu między sprawdzeniem warunku a zaśnięciem.
| Operacja | Co robi | Klucz |
|---|---|---|
FUTEX_WAIT(addr, val) | Zaśnij, jeśli *addr == val | Sprawdzenie i uśpienie są atomowe względem WAKE |
FUTEX_WAKE(addr, n) | Obudź do n wątków śpiących na addr | Zwykle n=1 (jeden) lub INT_MAX (wszyscy) |
Genialność FUTEX_WAIT polega na warunku *addr == val sprawdzanym atomowo w kernelu. Rozważ wyścig: wątek A widzi lock zajęty, postanawia zasnąć. Między tą decyzją a faktycznym zaśnięciem wątek B zwalnia lock i woła FUTEX_WAKE — ale A jeszcze nie śpi, więc budzenie trafia w próżnię. A zasypia na zawsze (lost wakeup).
Futex rozwiązuje to tak: FUTEX_WAIT przekazuje do kernela oczekiwaną wartość. Kernel atomowo sprawdza, czy *addr nadal ją ma — jeśli B zdążył ją zmienić, FUTEX_WAIT natychmiast wraca z EAGAIN zamiast zasnąć. Wątek nie zaśnie na nieaktualnym warunku. To jest właśnie sedno, którego naiwna implementacja „sprawdź flagę, potem śpij” nie ma.
Spinning vs sleeping — muteksy adaptacyjne
Czysty futex zasypia natychmiast przy kontencji. Ale uśpienie i obudzenie wątku to też koszt: przełączanie kontekstu, scheduling i zmiana lokalności cache. Jeśli lock jest trzymany krócej niż koszt uśpienia, taniej jest pokręcić się chwilę w pętli niż zasypiać. Stąd adaptacyjne muteksy (PTHREAD_MUTEX_ADAPTIVE_NP): najpierw spinują przez ograniczoną liczbę iteracji, a dopiero gdy to nie pomoże — wołają FUTEX_WAIT.
| Strategia | Zysk | Koszt |
|---|---|---|
| Czysty spin | Zero context switchy, najniższa latencja | Spala CPU przy długim trzymaniu locka |
| Czysty futex (sleep) | Zero spalania CPU przy czekaniu | Koszt context switcha nawet dla krótkich locków |
| Adaptacyjny | Spin dla krótkich, sleep dla długich | Heurystyka liczby spinów bywa nietrafiona |
Decyzja spin-vs-sleep to ten sam typ inżynierskiego trade-offu co wybór modelu I/O — gdzie narzut syscalla determinuje, czy warto sięgać po bardziej złożony mechanizm. Tę samą logikę „mierz, gdzie syscall faktycznie boli” rozkłada artykuł o epoll vs io_uring.
Thundering herd — kogo obudzić
Załóżmy, że 100 wątków śpi na jednym locku, a ten właśnie się zwalnia. Naiwne FUTEX_WAKE(addr, INT_MAX) obudzi wszystkie 100 — które rzucą się na lock, ale zdobędzie go jeden, a pozostałe 99 natychmiast wróci do snu. To thundering herd: 99 zbędnych context switchy, 99 nieudanych prób CAS, kompletne marnotrawstwo.
FUTEX_REQUEUE pozwala przenieść oczekujących do kolejki innego futeksa bez budzenia wszystkich naraz. To dostępny mechanizm optymalizacji, a nie gwarancja implementacji każdego pthread_cond_broadcast().
Futeksy międzyprocesowe
Futeksy mogą synchronizować wątki różnych procesów, jeśli słowo futeksa znajduje się w tej samej pamięci współdzielonej. Adresy wirtualne nie muszą być identyczne. Kernel wyznacza klucz futeksa na podstawie mapowania; sprowadzanie go wyłącznie do adresu fizycznego jest zbyt dużym uproszczeniem.
#include <sys/mman.h>

/* Mutex w pamięci współdzielonej — synchronizacja MIĘDZY procesami */
atomic_int *shared_mutex = mmap(
    NULL, sizeof(atomic_int),
    PROT_READ | PROT_WRITE,
    MAP_SHARED | MAP_ANONYMOUS,   /* współdzielone z procesami potomnymi */
    -1, 0
);

/* Sprawdź MAP_FAILED i zainicjalizuj atomic_init(shared_mutex, 0)
   przed fork(). Oba procesy używają operacji bez PRIVATE_FLAG. */
FUTEX_PRIVATE_FLAG jawnie informuje kernel, że futeks nie jest współdzielony między procesami, co umożliwia optymalizację wyszukiwania. Nie używaj tej flagi dla muteksa w pamięci współdzielonej przez różne procesy.
Priority inheritance — futeksy PI
Klasyczny problem czasu rzeczywistego: inwersja priorytetów. Wątek niskopriorytetowy trzyma lock, którego potrzebuje wątek wysokopriorytetowy. Ten wysoki czeka — ale wątek średniopriorytetowy wywłaszcza niski, więc lock nie zostaje zwolniony, a wysoki priorytet czeka w nieskończoność, zablokowany pośrednio przez średni.
Kernel rozwiązuje to przez PI futexes (FUTEX_LOCK_PI): gdy wysokopriorytetowy wątek blokuje się na locku trzymanym przez niski, kernel tymczasowo podnosi priorytet posiadacza locka do poziomu czekającego. Niski wątek kończy sekcję krytyczną szybciej, zwalnia lock i wraca do swojego priorytetu. To kluczowy mechanizm dla systemów real-time i sterowników, gdzie deterministyczne czasy reakcji są wymogiem, nie luksusem.
Diagnostyka — narzędzia
| Narzędzie | Zastosowanie |
|---|---|
strace -e trace=futex | Które wywołania futex faktycznie trafiają do kernela |
strace -c | Liczba syscalli futex; interpretuj ją wraz z czasem oczekiwania i stosami |
perf lock record/report | Kontencja blokad kernela; nie jest ogólnym profilerem pthread_mutex |
perf trace -e futex | Futex syscalls z latencją w czasie rzeczywistym |
/proc/<pid>/status | Stan wątku; miejsce oczekiwania sprawdź też w /proc/<pid>/task/<tid>/wchan |
eu-stack / gdb | Gdzie wątek utknął: stack trace w FUTEX_WAIT |
Dużo wywołań futex to wskazówka do dalszej analizy. Mogą pochodzić także ze zmiennych warunkowych, semaforów i innych prymitywów. Sprawdź czas oczekiwania oraz stosy wątków, zanim uznasz je za dowód kontencji konkretnego muteksa. Pomaga w tym czytanie syscalli w strace.
Kiedy to się liczy — decision matrix
| Scenariusz | Implikacja |
|---|---|
| Lock bez kontencji (typowy przypadek) | Fast path w userspace; koszt zależy od sprzętu i cache |
| Krótka sekcja krytyczna, wysoka kontencja | Rozważ mutex adaptacyjny lub spinlock |
| Długa sekcja krytyczna | Czysty futex (sleep) — nie spalaj CPU |
| Setki tysięcy futex/s w strace | Sprawdź, które prymitywy generują wywołania i ile trwa oczekiwanie |
| Synchronizacja między procesami | Futex w pamięci MAP_SHARED; potrzebny poprawny protokół synchronizacji |
| System real-time / sterowniki | PI futex — ochrona przed inwersją priorytetów |
| Bardzo wysoka kontencja, wiele rdzeni | Rozważ lock-free struktury (CAS bez locka) |
Podsumowanie: futex jako warstwa, którą warto rozumieć
Sprawdzaj dwie rzeczy osobno: poprawność protokołu oczekiwania i koszt kontencji. Powrót z FUTEX_WAIT nie oznacza zdobycia blokady — o tym decyduje ponowna operacja atomowa w userspace.
Brak syscalla nie oznacza zerowego kosztu. Nawet szybka ścieżka może przenosić linię cache między rdzeniami. Mierz cały workload, zanim zamienisz mutex na spinlock albo strukturę lock-free.
Powiązane artykuły
- epoll vs io_uring — kiedy event loop przestaje wystarczać — ten sam trade-off narzutu syscalla, w kontekście I/O
- mmap — kiedy memory-mapped I/O bije read() i write() — MAP_SHARED jako fundament futeksów międzyprocesowych
- fork() Linux — co naprawdę robi pod spodem — procesy, wątki i współdzielenie pamięci
- strace — czytanie syscalli, kiedy stack trace nie wystarcza — obserwacja wywołań futex w praktyce
Weryfikacja techniczna: futex(2), FUTEX_WAIT, perf-lock(1).