Wysyłasz SIGTERM, a proces dalej działa. Po SIGKILL może zakończyć pracę, ale przez chwilę pozostać w ps jako zombie. Z kolei handler uruchomiony podczas blokującego wywołania potrafi sprawić, że syscall zwróci EINTR. Sygnały wyglądają prosto — wyślij numer, proces reaguje — dopóki nie trzeba wyjaśnić tych różnic.
Ten artykuł rozkłada sygnały na części: czym naprawdę jest dostarczenie sygnału, dlaczego niektórych nie da się złapać, jak SIGCHLD wiąże się z mechanizmem fork() i procesami zombie, oraz które operacje wolno wykonać w handlerze, a które wysadzą Ci proces w powietrze.
Czym jest sygnał — z perspektywy kernela
Sygnał to powiadomienie obsługiwane przez kernel. Może wynikać z działania innego procesu albo z błędu bieżącej instrukcji, jak SIGSEGV. Sygnały standardowe nie kolejkują kolejnych wystąpień tego samego numeru; sygnały czasu rzeczywistego mają inną semantykę i mogą być kolejkowane.
Maska blocked należy do wątku. Sygnały pending są wygenerowane, ale jeszcze niedostarczone; mogą oczekiwać dla całego procesu albo konkretnego wątku. Dyspozycja, czyli sposób reagowania na dany sygnał, jest wspólna dla wątków procesu.
Kiedy proces A robi kill(pid_B, SIGTERM), kernel nie przekazuje sterowania natychmiast do procesu B. Ustawia bit SIGTERM w masce pending procesu B i wraca. Faktyczne dostarczenie — moment, w którym proces B przerywa to, co robił, i wykonuje akcję dla sygnału — następuje dopiero przy najbliższym przejściu z trybu kernela do trybu użytkownika: zwykle po powrocie z syscalla albo z przerwania zegarowego.
To rozróżnienie między wygenerowaniem a dostarczeniem sygnału jest źródłem większości nieintuicyjnych zachowań. Proces zablokowany w długim syscallu może mieć sygnał w pending przez dłuższą chwilę, zanim go obsłuży.
Dyspozycje sygnałów: trzy możliwe reakcje
Dla każdego sygnału proces ma ustawioną jedną z trzech dyspozycji (signal disposition), która decyduje, co się stanie przy dostarczeniu:
- Akcja domyślna (
SIG_DFL) — zachowanie zdefiniowane przez kernel: zakończenie procesu, zakończenie ze zrzutem pamięci, zignorowanie albo zatrzymanie. - Ignorowanie (
SIG_IGN) — sygnał jest odrzucany przy dostarczeniu. - Handler — funkcja użytkownika rejestrowana przez
sigaction(), wywoływana w kontekście procesu w momencie dostarczenia.
Domyślne akcje dla najczęstszych sygnałów wyglądają tak:
Numery w tabeli dotyczą m.in. x86-64. W kodzie używaj nazw SIGTERM czy SIGCHLD, bo numeracja części sygnałów zależy od architektury. Zrzut core zależy dodatkowo od konfiguracji systemu.
| Sygnał | Numer | Akcja domyślna | Można złapać? | Typowe źródło |
|---|---|---|---|---|
| SIGTERM | 15 | Zakończenie | Tak | Uprzejma prośba o zamknięcie (kill) |
| SIGKILL | 9 | Zakończenie | Nie | Wymuszone zabicie procesu |
| SIGINT | 2 | Zakończenie | Tak | Ctrl+C w terminalu |
| SIGSEGV | 11 | Zrzut pamięci | Tak | Naruszenie ochrony pamięci |
| SIGCHLD | 17 | Ignorowanie | Tak | Zmiana stanu procesu potomnego |
| SIGSTOP | 19 | Zatrzymanie | Nie | Wstrzymanie procesu |
| SIGHUP | 1 | Zakończenie | Tak | Rozłączenie terminala / reload configu |
SIGKILL i SIGSTOP — dlaczego nie da się ich złapać
Dwa sygnały — SIGKILL (9) i SIGSTOP (19) — są nieprzechwytywalne z definicji. Nie zarejestrujesz dla nich handlera, nie ustawisz ich na ignorowanie, nie zablokujesz ich maską. Kernel obsługuje je sam, bez oddawania sterowania procesowi.
To celowa decyzja projektowa. Gdyby proces mógł przechwycić SIGKILL, mógłby zignorować polecenie zakończenia i stać się nieubijalny. SIGKILL jest mechanizmem ostatniej szansy dla systemu operacyjnego — możliwością wymuszenia zakończenia bez zgody kodu użytkownika, gdy kernel może je wykonać. Próba ustawienia handlera kończy się błędem EINVAL:
#include <signal.h>
#include <stdio.h>
#include <errno.h>
#include <string.h>

int main(void) {
    struct sigaction sa = {0};
    sa.sa_handler = SIG_IGN;

    if (sigaction(SIGKILL, &sa, NULL) == -1) {
        // errno == EINVAL: SIGKILL nie może mieć handlera
        fprintf(stderr, "sigaction(SIGKILL): %s\n", strerror(errno));
    }
    return 0;
}
Brak reakcji na SIGTERM ma kilka możliwych przyczyn: sygnał jest zablokowany lub ignorowany, handler jeszcze sprząta zasoby albo wykonanie utknęło w kernelu. Przy nieprzerywalnym oczekiwaniu nawet SIGKILL może zadziałać dopiero po opuszczeniu tego stanu.
SIGCHLD i procesy zombie
Tu sygnały spotykają się z zarządzaniem procesami. Kiedy proces potomny kończy działanie, kernel wysyła SIGCHLD do rodzica i — co kluczowe — utrzymuje minimalny wpis o procesie potomnym w tablicy procesów. Ten wpis zawiera kod wyjścia, statystyki zużycia zasobów i PID. Proces w tym stanie to zombie (stan Z): nie wykonuje już żadnego kodu, ale zajmuje slot w tablicy procesów.
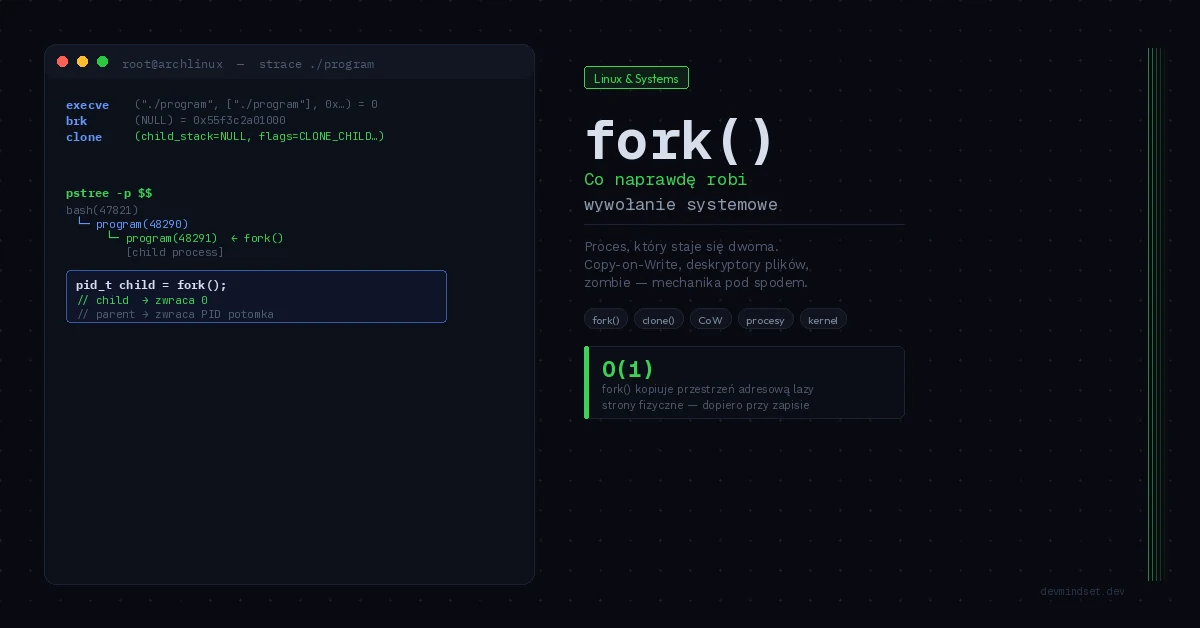
Wpis znika dopiero, gdy rodzic wykona wait() lub waitpid() i odbierze kod wyjścia — operację nazywamy reaping (żniwa). To samo zagadnienie opisałem szczegółowo od strony tworzenia procesów w artykule o tym, co naprawdę robi fork() w Linuksie; tutaj patrzymy na nie od strony sygnałów.
Domyślna akcja SIGCHLD to ignorowanie sygnału, ale pozostawienie SIG_DFL nie usuwa zombie. Rodzic odbiera status przez wait() lub waitpid(). Na Linuksie jawne ustawienie SIG_IGN albo SA_NOCLDWAIT zmienia to zachowanie i zapobiega pozostawianiu zombie. Jeśli chcesz odbierać statusy w handlerze, potrzebujesz pętli:
#include <errno.h>
#include <signal.h>
#include <sys/wait.h>
#include <unistd.h>

// Reaper: odbiera WSZYSTKIE zakończone procesy potomne.
// Pętla jest konieczna — pojedynczy SIGCHLD może reprezentować
// wiele zakończonych dzieci (sygnały się nie kolejkują).
void sigchld_handler(int signo) {
    (void)signo;
    int saved_errno = errno;   // handler musi zachować errno
    pid_t pid;

    while ((pid = waitpid(-1, NULL, WNOHANG)) > 0) {
        // zreapowano proces o danym PID
    }

    errno = saved_errno;
}

int install_reaper(void) {
    struct sigaction sa = {0};
    sa.sa_handler = sigchld_handler;
    sigemptyset(&sa.sa_mask);
    sa.sa_flags = SA_RESTART | SA_NOCLDSTOP;  // restart wybranych syscalli; bez SIGCHLD przy stop/cont

    return sigaction(SIGCHLD, &sa, NULL);
}
Pętla while z WNOHANG jest tu nieprzypadkowa. Sygnały standardowe nie kolejkują się: jeśli trzy procesy potomne zakończą się w krótkim odstępie, zanim handler zdąży się uruchomić, dostaniesz tylko jeden SIGCHLD, nie trzy. Handler, który wywołuje waitpid() tylko raz, zreapuje jedno dziecko i zostawi dwa zombie. Pętla odbiera wszystkie dostępne na raz.
Async-signal-safety: co wolno w handlerze
Handler sygnału wykonuje się asynchronicznie — może przerwać główny kod procesu w dowolnym momencie, również w środku wywołania biblioteki standardowej. To prowadzi do najczęstszego błędu w obsłudze sygnałów: wywołania funkcji, która nie jest async-signal-safe.
Wyobraź sobie, że proces jest w środku malloc(), który właśnie modyfikuje wewnętrzne struktury sterty i trzyma blokadę. Przychodzi sygnał, handler wywołuje printf() — który wewnętrznie też woła malloc(). Druga alokacja próbuje wziąć tę samą blokadę, którą trzyma przerwany kod. Rezultat to deadlock albo uszkodzenie sterty. To samo dotyczy każdej funkcji, która operuje na współdzielonym stanie globalnym.
POSIX definiuje wąską listę funkcji gwarantowanych jako async-signal-safe. Najważniejsze z nich:
| Bezpieczne w handlerze | NIEbezpieczne — nigdy w handlerze |
|---|---|
write() | printf(), fprintf() |
read() | malloc(), free() |
waitpid() | fopen(), fclose() |
_exit() | exit() (woła atexit) |
signal(), sigaction() | większość funkcji stdio |
kill() | funkcje operujące na lokalizacji (setlocale) |
Praktyczny wzorzec: handler powinien być maksymalnie krótki. W idealnym przypadku ustawia tylko flagę typu volatile sig_atomic_t i wraca, a całą logikę wykonuje główna pętla programu po sprawdzeniu flagi. Jeśli handler musi zalogować informację, używa write() bezpośrednio na deskryptorze, nigdy printf().
Poniższa pętla jest szkieletem — w prawdziwym programie musi wykonywać pracę lub czekać na zdarzenia. Sama flaga sig_atomic_t nie zastępuje synchronizacji między wątkami.
#include <signal.h>
#include <unistd.h>

// Flaga modyfikowana przez handler, odczytywana przez główną pętlę.
// volatile: kompilator nie może jej cache'ować w rejestrze.
// sig_atomic_t: gwarancja atomowego zapisu/odczytu.
static volatile sig_atomic_t shutdown_requested = 0;

void handle_term(int signo) {
    shutdown_requested = 1;
    // opcjonalny log — write() jest async-signal-safe
    const char msg[] = "SIGTERM odebrany, zamykanie\n";
    write(STDERR_FILENO, msg, sizeof(msg) - 1);
}

int main(void) {
    struct sigaction sa = {0};
    sa.sa_handler = handle_term;
    sigemptyset(&sa.sa_mask);
    sa.sa_flags = SA_RESTART;
    sigaction(SIGTERM, &sa, NULL);

    while (!shutdown_requested) {
        // główna pętla: tu wykonujesz całą realną pracę,
        // łącznie z czyszczeniem zasobów po wykryciu flagi
    }

    // graceful shutdown poza handlerem — tu wolno wszystko
    return 0;
}
SA_RESTART i przerwane syscalle
Jest jeszcze jeden mechanizm, który zaskakuje przy pierwszym kontakcie. Kiedy sygnał zostaje dostarczony w trakcie blokującego syscalla — na przykład read() czekającego na dane z gniazda — syscall może zostać przerwany i zwrócić błąd EINTR zamiast dokończyć operację.
SA_RESTART automatycznie wznawia wybrane wywołania. Możesz też jawnie obsłużyć EINTR, ale decyzja zależy od operacji: przy zamykaniu aplikacji bezwarunkowe ponawianie odczytu może opóźnić wyjście.
#include <unistd.h>
#include <errno.h>

// Wrapper odporny na przerwanie sygnałem.
// Ponawia read() przy EINTR zamiast traktować to jak błąd.
ssize_t read_retry(int fd, void *buf, size_t count) {
    ssize_t n;
    do {
        n = read(fd, buf, count);
    } while (n == -1 && errno == EINTR);
    return n;
}
Uwaga: SA_RESTART nie działa dla wszystkich syscalli. Część z nich — między innymi te związane z czekaniem na zdarzenia, jak część wariantów poll() czy operacje na timerach — zwraca EINTR niezależnie od flagi. Dlatego defensywny kod sieciowy i tak powinien obsługiwać EINTR jawnie, nawet z ustawionym SA_RESTART.
Diagnostyka: podglądanie sygnałów w działającym procesie
Kiedy proces zachowuje się dziwnie wobec sygnałów, nie musisz zgadywać. Plik /proc/<pid>/status pokazuje aktualne maski sygnałów w postaci szesnastkowej:
$ grep -E 'Sig|Shd' /proc/$(pgrep -n nginx)/status
SigQ:   0/31228          # sygnały w kolejce / limit
SigPnd: 0000000000000000 # pending dla tego wątku
SigBlk: 0000000000000000 # zablokowane (maska)
SigIgn: 0000000000001000 # ignorowane
SigCgt: 0000000180014a07 # przechwytywane (mają handler)
Każdy bit odpowiada jednemu sygnałowi (bit 0 = sygnał 1). Maska SigCgt mówi, które sygnały proces obsługuje własnym handlerem — przydatne, gdy chcesz sprawdzić, czy aplikacja w ogóle reaguje na SIGHUP (reload configu), zanim wyślesz go na produkcji.
strace pokazuje dostarczone sygnały i powroty z handlerów. Sposób czytania takiego śladu rozwijam w artykule o diagnostyce syscalli przez strace. Filtr syscalli trace=%signal i filtr dostarczanych sygnałów signal=all pełnią różne role.
$ strace -e trace=%signal -e signal=all -p <pid>
--- SIGTERM {si_signo=SIGTERM, si_code=SI_USER, si_pid=4821} ---
rt_sigreturn({mask=[]})  = 202
# widać dostarczenie SIGTERM i powrót z handlera
Podsumowanie
Sygnały w Linuksie to nie prosty mechanizm „wyślij liczbę, proces reaguje”. To asynchroniczny interfejs z trzema warstwami subtelności: rozróżnieniem między wygenerowaniem a dostarczeniem, ograniczeniami tego, co wolno zrobić w handlerze, i niekolejkowaniem sygnałów standardowych. Najczęstsze bugi biorą się z ignorowania tych trzech rzeczy — handler wołający printf(), reaper bez pętli while, kod sieciowy nieobsługujący EINTR.
Reguła praktyczna: traktuj handler jak kod przerwania sprzętowego. Im mniej w nim robisz, tym mniej rzeczy może pójść źle. Ustaw flagę, wróć, obsłuż resztę w głównej pętli — i nigdy nie zakładaj, że jeden sygnał oznacza jedno zdarzenie.
Weryfikacja techniczna: signal(7), signal-safety(7).