Wywołujesz fork() i masz dwa procesy. Potem log pojawia się dwa razy, offset pliku zmienia się w rodzicu albo dziecko zatrzymuje się na muteksie. Żeby wyjaśnić te przypadki, trzeba wiedzieć, co Linux kopiuje, a co pozostaje współdzielone.
Co mówi dokumentacja — i dlaczego to za mało
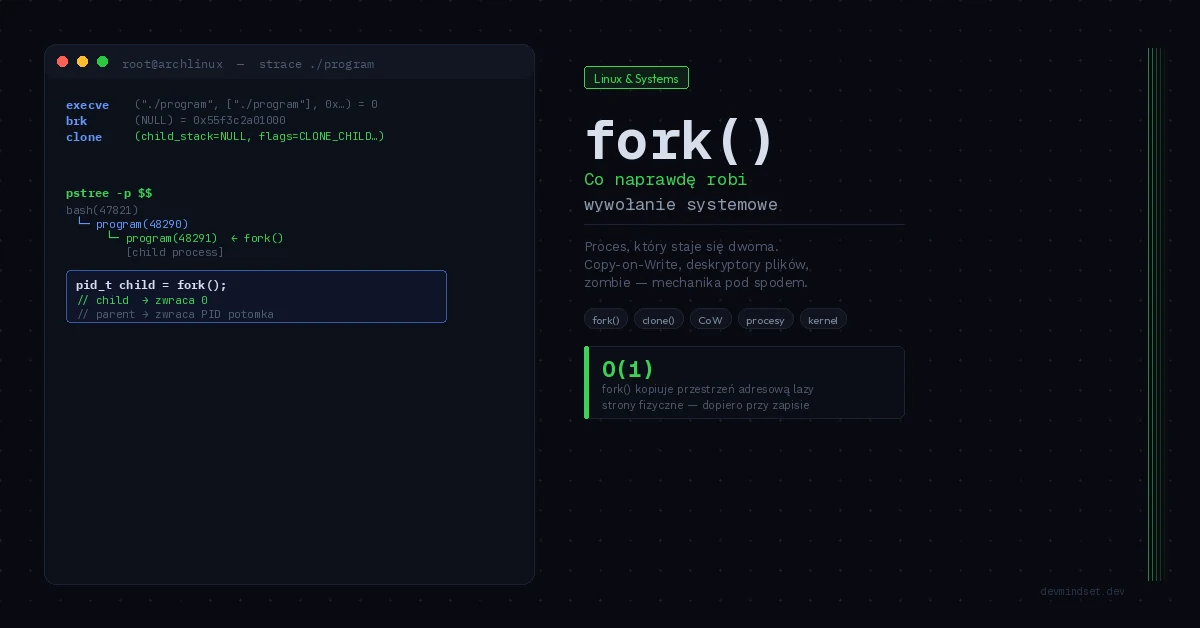
man fork powie Ci, że wywołanie tworzy nowy proces będący kopią procesu rodzica. Zwraca 0 w procesie dziecka i PID dziecka w procesie rodzica. Klasyczny przykład wygląda tak:
pid_t pid = fork();
if (pid == 0) {
    // tu jesteśmy w dziecku
} else if (pid > 0) {
    // tu jesteśmy w rodzicu
} else {
    // fork() się nie powiódł
}
Ten schemat opisuje wynik wywołania. Do przewidzenia zachowania programu potrzebujesz jeszcze reguł dziedziczenia pamięci, deskryptorów i stanu bibliotek.
Copy-on-write: dlaczego fork nie kopiuje od razu całej pamięci
Gdyby fork() od razu kopiował wszystkie strony pamięci procesu, koszt utworzenia dziecka rósłby wraz z ilością kopiowanych danych. Przy częstym tworzeniu procesów mogłoby to ograniczać przepustowość serwera.
Linux rozwiązuje to przez mechanizm Copy-on-Write (CoW).
W typowym przypadku prywatne, zapisywalne strony rodzica i dziecka początkowo wskazują tę samą pamięć fizyczną. Kernel chroni je przed bezpośrednim zapisem, żeby obsłużyć copy-on-write. To uproszczenie dotyczące prywatnych mapowań — mapowania współdzielone mają inną semantykę.
Kopiowanie następuje dopiero wtedy, gdy którykolwiek z procesów — rodzic lub dziecko — próbuje zapisać do danej strony. Jądro wyłapuje to jako page fault, tworzy kopię konkretnej strony, przypisuje ją do procesu który chciał pisać, i kontynuuje wykonanie. Drugi proces nadal widzi oryginał.
fork() nie ma kosztu O(1) niezależnego od rozmiaru procesu. Trzeba m.in. utworzyć struktury procesu i skopiować tablice stron. CoW pozwala odroczyć kopiowanie danych, ale rozmiar i układ przestrzeni adresowej nadal wpływają na koszt.
Deskryptory plików i subtelność której nie widać
fork() dziedziczy też otwarte deskryptory plików. Tu słowo „kopia” łatwo prowadzi do złego wniosku.
Dziecko dostaje własną tablicę deskryptorów. Odpowiadające sobie wpisy wskazują jednak te same open file descriptions w kernelu, więc współdzielą m.in. offset i flagi stanu pliku.
To ma bezpośrednie konsekwencje:
Jeśli rodzic ma otwarty plik i zapisał do pozycji 100, dziecko widzi offset jako 100. Jeśli dziecko zapisze 50 bajtów, offset przeskakuje do 150 — i rodzic, gdy następnie zapisuje, zaczyna od 150, nie od 100.
Wspólny offset sam w sobie nie oznacza wzajemnego nadpisywania danych. Równoległe zapisy mogą jednak przeplatać rekordy, a skopiowane bufory biblioteki stdio mogą zostać opróżnione dwukrotnie. To różne problemy i wymagają różnych poprawek.
Zamknij deskryptory, których dziecko nie potrzebuje. dup2() służy m.in. do przekierowania strumieni, ale nadal współdzieli ten sam opis otwartego pliku i offset. Jeśli potrzebujesz niezależnego offsetu, ponowne open() tworzy osobny opis; nie rozwiązuje to automatycznie koordynacji zapisów do wspólnego pliku.
Signal handlers, muteksy i problemy których nie spodziewasz się w dziecku
Po fork() dziecko dziedziczy signal handlers zdefiniowane przez rodzica. To jest udokumentowane i często oczekiwane.
Szczegóły masek, sygnałów oczekujących i SIGCHLD rozwija tekst o sygnałach w Linuksie.
Co jest mniej oczywiste: dziecko dziedziczy również stan muteksów.
Po fork() w dziecku pozostaje tylko wątek wywołujący. Stan muteksu trzymanego przez inny wątek może zostać skopiowany bez wątku, który go zwolni. Próba użycia takiego muteksu może spowodować deadlock. Biblioteki mogą mieć własną obsługę fork, więc nie każdy ich wewnętrzny muteks zachowa się identycznie.
To jest jeden z powodów dla których POSIX definiuje pthread_atfork() — mechanizm rejestrowania handlerów wywoływanych przed i po fork(), które mogą czyścić stan muteksów.
W dziecku procesu wielowątkowego do czasu execve() ogranicz się do funkcji async-signal-safe. pthread_atfork() pomaga zarządzać znanym stanem, ale nie naprawia automatycznie wszystkich bibliotek. Jeśli celem jest uruchomienie programu, rozważ również posix_spawn().
fork i exec: nowy proces, potem nowy program
Sam fork() rzadko jest celem — jest środkiem. Standardowy wzorzec to fork() + exec():
To fragment, nie kompletny program: wymaga m.in. <unistd.h>, poprawnej tablicy args, obsługi błędu fork() i odebrania statusu dziecka przez rodzica. Po nieudanym execv() używamy _exit(), żeby nie uruchamiać odziedziczonych procedur końcowych i nie opróżniać ponownie buforów stdio.
pid_t pid = fork();
if (pid == 0) {
    execv("/usr/bin/program", args);
    // jeśli execv zwróci — coś poszło nie tak
    _exit(1);
}
execv() zastępuje obraz procesu dziecka całkowicie nowym programem. Wszystko co załadował fork() — cały adresowy obszar rodzica — zostaje wyrzucone i zastąpione nowym plikiem wykonywalnym.
Jeśli dziecko szybko wywołuje exec(), unika kopiowania dużej części odziedziczonych danych. Nie znaczy to, że nie zapisze żadnej strony przed zmianą programu — sam kod wykonywany pomiędzy fork() a exec() może modyfikować pamięć.
To jest fundament na którym stoi cały model procesu w Unixie — i dlaczego uruchamianie nowych procesów jest w Linuksie szybsze niż mogłoby się wydawać.
Zombie i sieroty — dwa problemy które widzisz w ps aux
Zombie to zakończony proces, którego statusu rodzic jeszcze nie odebrał. Zasadniczo robi to przez wait() lub waitpid(); reguły zmieniają m.in. ustawienia obsługi SIGCHLD. Sierota to inna sytuacja: dziecko nadal działa, ale jego rodzic już zakończył pracę.
Przy dużej liczbie procesów zombie zajmują wpisy w tablicy procesów jądra — a ta ma ograniczony rozmiar. Serwer który spawnuje procesy bez właściwego wait() może w końcu wyczerpać limit i przestać tworzyć nowe procesy.
W ps aux rozpoznasz zombie po literze Z w kolumnie STATE i <defunct> przy nazwie procesu.
Osierocony proces przejmuje najbliższy odpowiedni subreaper albo proces init w danej przestrzeni nazw PID. Nowy rodzic powinien odbierać status zakończenia dzieci. Nie zakładaj, że zawsze będzie to systemowy PID 1 poza kontenerem.
Co to zmienia w praktyce
Gdy śledzisz tworzenie procesów, oddziel trzy pytania: co dziedziczy dziecko, co później zmienia exec() i kto odbiera status zakończenia.
Za każdym razem gdy coś niespodziewanego dzieje się z pamięcią lub plikami po rozwidleniu — wiesz teraz gdzie szukać. To samo podejście hipotez i dedukcji które opisałem w artykule o debugowaniu stosuje się tutaj bezpośrednio.
Model „fork kopiuje proces” nie jest fałszywy. Jest po prostu za mało precyzyjny żeby rozwiązywać problemy.
Jak to zbadać samemu
Na Linuksie możesz użyć strace i informacji z /proc. strace może wymagać instalacji, a możliwość śledzenia zależy od uprawnień.
# Obserwuj tworzenie procesów i wywołania systemowe
strace -f -e trace=%process twój_program
# Sprawdź mapę pamięci procesu przed i po fork()
cat /proc/PID/maps
strace -f śledzi wywołania systemowe we wszystkich procesach potomnych — flaga -f oznacza „follow forks”. Widząc surowe wywołania systemowe zamiast abstrakcji biblioteki C, przestajesz zgadywać co robi system.
/proc/PID/maps pokazuje zakresy mapowań, nie dowodzi współdzielenia tych samych stron fizycznych. Do analizy pamięci przydaje się także /proc/PID/smaps. Zachowanie wartości po fork możesz obejrzeć w process_demo.py. Uruchom przykład przez python3 -u process_demo.py, żeby wyjście dziecka nie zniknęło w buforze przy os._exit().
To, co dzieje się z przestrzenią adresową i stronami copy-on-write po wywołaniu fork(), łączy się bezpośrednio z mechaniką błędu opisaną w tekście o anatomii segfaulta — od MMU przez kernel po core dump w gdb. Proces, który właśnie utworzyłeś, możesz uruchomić z limitami zasobów — o czym jest materiał o cgroups v2 bez Dockera.
Weryfikacja techniczna: fork(2), dup(2): współdzielony offset.