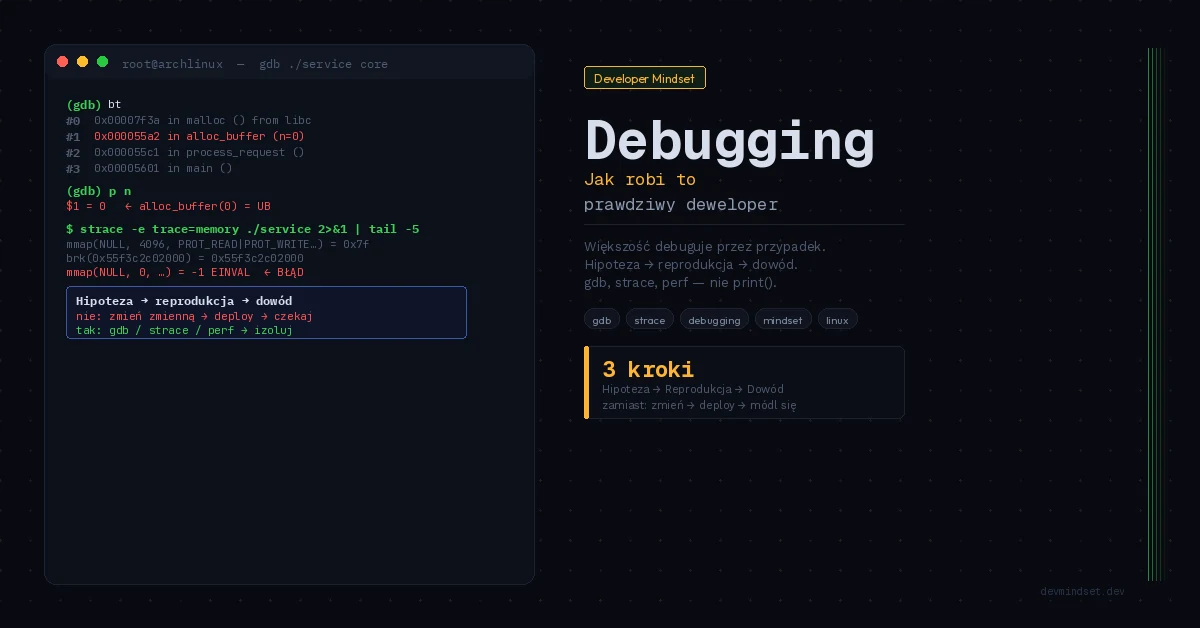
Masz błąd w produkcji. Patrzysz na stack trace, otwierasz wskazany plik i zaczynasz grzebać. Zmieniasz jedną zmienną, deployujesz, czekasz. Nie pomogło. Zmieniasz drugą. Czekasz. Może tym razem.
To nie jest debugging. To hazard z kodem produkcyjnym.
Poprawka może zadziałać, a ty nadal nie wiedzieć dlaczego. Przy następnej awarii wrócisz do zgadywania. Warto zbudować proces, który prowadzi od obserwacji do sprawdzonej przyczyny.
Przypadkowe zmiany dają iluzję kontroli
Klasyczne objawy złego debugowania:
- Dodajesz
console.loglubprint()w losowych miejscach kodu - Zmieniasz kilka rzeczy naraz, bo „może któraś z nich to naprawi”
- Szukasz na Stack Overflow zanim w pełni zrozumiesz błąd
- Restartujesz serwis, ale nie zapisujesz obserwacji, które pomogłyby odróżnić przywrócenie działania od usunięcia przyczyny
- Opisujesz problem jako „coś się psuje” zamiast konkretnego zachowania
Każdy z tych nawyków ma jeden wspólny mianownik: działasz bez hipotezy. Bez hipotezy nie debugujesz — zgadujesz.
Jak myśli programista, który naprawdę debuguje
Potrzebujesz zarówno obserwacji, jak i sprawdzania hipotez. Eksploracja pomaga poznać system; problem zaczyna się wtedy, gdy kolejne zmiany nie odpowiadają na żadne konkretne pytanie.
Eksploracja: sprawdzasz przepływ danych i warunki, w których pojawia się błąd. Zbierasz materiał do hipotezy.
Dedukcja oznacza: „Wiem jak system powinien działać. Obserwuję jak działa. Różnica między oczekiwaniem a obserwacją to mój punkt startowy.”
Zanim dotkniesz kodu, musisz odpowiedzieć na trzy pytania:
1. Jakie jest dokładne, powtarzalne zachowanie systemu?
Nie „coś się psuje przy logowaniu”. Konkretnie: „Użytkownik z emailem zawierającym znak + nie może się zalogować. Błąd pojawia się wyłącznie przy metodzie OAuth, nie przy logowaniu hasłem. Reprodukuję na środowisku staging, nie reprodukuję lokalnie.”
Im precyzyjniej opisujesz problem, tym szybciej go rozwiążesz. To nie pedanteria — to podstawowa higiena debugowania.
2. Jakie jest Twoje oczekiwane zachowanie i skąd to wiesz?
Musisz mieć punkt odniesienia. Czy masz dokumentację? Testy? Poprzedni commit gdzie działało? Bez odpowiedzi na to pytanie nie wiesz nawet czego szukasz.
3. Jaka jest Twoja hipoteza?
Jedna konkretna hipoteza, zanim zaczniesz cokolwiek zmieniać. „Podejrzewam że URL encoder w bibliotece X nie obsługuje znaku + w parametrze email.” Następnie weryfikujesz tę hipotezę — i tylko tę hipotezę. Jeśli okazuje się fałszywa, formujesz kolejną.
Narzędzia które zmieniają perspektywę
Debugger może pomóc zarówno postawić hipotezę, jak i ją obalić. Przed kolejnym breakpointem określ, czego chcesz się dowiedzieć: czy dane są już błędne, która gałąź została wykonana, kto zmienił wartość?
Binary search na kodzie
Jeśli potrafisz rozpoznać poprawny stan w kolejnych punktach przepływu, sprawdź jego środek. Dane są już błędne czy jeszcze poprawne? Zawężaj odcinek, w którym zmieniły się niezgodnie z oczekiwaniem. Przypomina to wyszukiwanie binarne, ale nie daje ogólnej gwarancji O(log n) dla debugowania — szczególnie przy współbieżności i błędach zależnych od czasu.
Izolacja zmiennych
Każda zmiana w środowisku to potencjalna przyczyna. Zanim zaczniesz szukać w kodzie, zadaj pytanie: co się zmieniło od ostatniego momentu kiedy działało? Nowa wersja biblioteki? Zmiana konfiguracji? Migracja bazy danych? Commit sprzed tygodnia?
git bisect pomaga znaleźć zmianę wprowadzającą regresję między znaną dobrą i złą wersją. Potrzebujesz wiarygodnego sposobu klasyfikowania kolejnych wersji. Niestabilny test albo błąd, który znika i wraca niezależnie od zmian, może podważyć wynik.
Logi jako narracja, nie jako szum
Logi czytasz jak detektyw czyta zeznania świadków — szukasz niespójności, nie potwierdzenia swojej teorii. Jeśli logujesz tylko błędy, ślepy jesteś na to co dzieje się tuż przed błędem. Dobry log to kontekst: kto, co, kiedy, z jakimi danymi wejściowymi.
Błąd który kosztuje godziny: debugowanie objawu zamiast przyczyny
Stack trace wskazuje linię 203. To dobry punkt startowy, ale jeszcze nie dowód, że właśnie tam powstał błąd.
Linia 203 to miejsce gdzie system krzyczy — nie miejsce gdzie popełniono zbrodnię. Błąd logiczny często pojawia się 10, 20, 50 linii wcześniej, w miejscu gdzie dane wchodzą do systemu w złym stanie. Linia 203 tylko jako pierwsza nie daje rady z tym poradzić.
Naucz się czytać stack trace od góry, ale myśleć o nim od dołu. Gdzie dane weszły do systemu? Co miały zawierać? Co zawierają faktycznie? Gdzieś między wejściem a objawem leży przyczyna.
Kiedy utknąłeś: technika gumowej kaczki
Masz 45 minut w problemie i nic. Nie otwieraj Stack Overflow. Zamiast tego wytłumacz problem na głos — dosłownie, słowami — komukolwiek obok. Albo gumowej kaczce na biurku. Albo plikowi tekstowemu.
Opisując problem po kolei, musisz nazwać założenia, które wcześniej pomijałeś. Czasem sprzeczność wychodzi już w trakcie tłumaczenia. Nawet jeśli nie znajdziesz od razu rozwiązania, zostaje konkretny opis do dalszej pracy.
Jeśli nie masz do kogo mówić, pisz. GitHub Issues, Slack do siebie samego, notatnik. Pełny opis problemu: co widzisz, czego oczekujesz, co już sprawdziłeś, jaka jest Twoja aktualna hipoteza.
Gdy hipoteza dotyczy zachowania poza kodem aplikacji — plików, uprawnień lub połączeń — przydaje się strace i analiza wywołań systemowych. Narzędzie dobierz do pytania, które chcesz rozstrzygnąć.
Co zrobić inaczej od dziś
Następnym razem gdy trafisz na błąd, zanim dotkniesz kodu — napisz w komentarzu lub pliku tekstowym trzy zdania:
- Dokładne, powtarzalne zachowanie, które obserwujesz.
- Dokładne zachowanie, którego oczekujesz i skąd to wiesz.
- Twoja pierwsza hipoteza o przyczynie.
Jeśli brakuje odpowiedzi, wróć do obserwacji. Przy trudnym do odtworzenia błędzie zapisz też, czego jeszcze nie wiesz i jakie dane pozwolą to sprawdzić.
To nawyk, który oddziela programistów którzy „jakoś to naprawiają” od tych, którzy rozumieją co naprawiają i dlaczego.
Metodyczne dochodzenie do przyczyny ma swój najbardziej namacalny przypadek w analizie awarii pamięci — rozkłada ją na czynniki pierwsze tekst o anatomii segfaulta, od MMU przez kernel po core dump w gdb. Sama umiejętność dedukcji, na której opiera się cały ten proces, zaczyna się zaś od poznawania cudzego kodu od punktów wejścia — bo w obu przypadkach budujesz model systemu, zanim go dotkniesz.