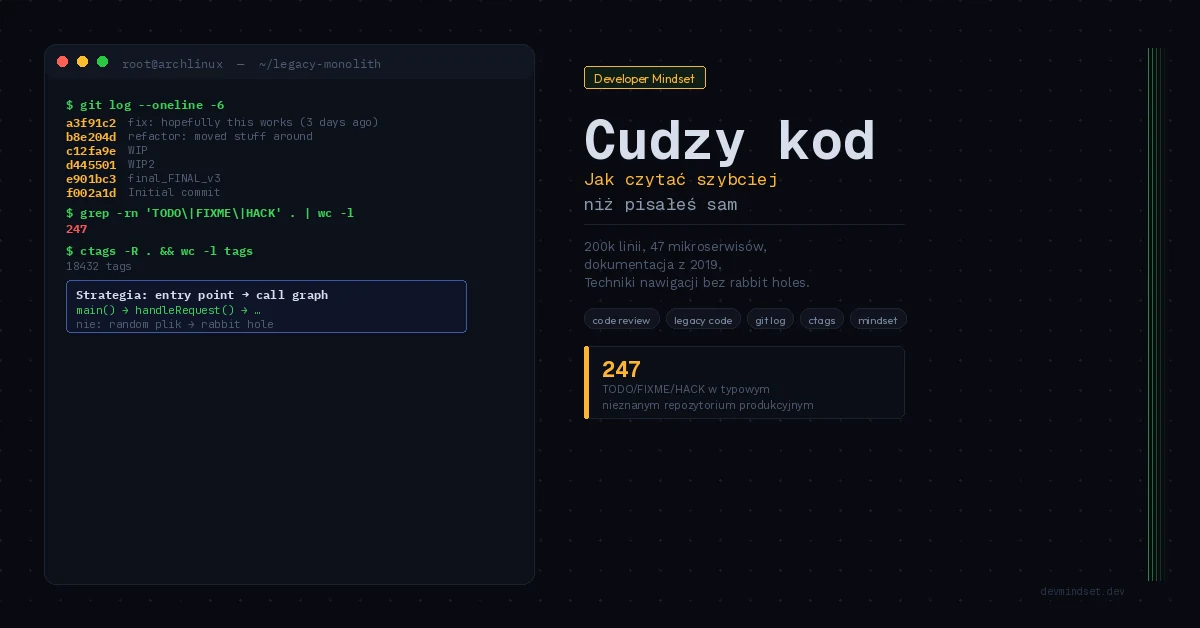
Dostajesz repozytorium, które ma 200 tysięcy linii, 47 mikroserwisów i dokumentację z 2019 roku. Otwierasz IDE, klikasz losowy plik, scrollujesz, zamykasz. Otwierasz drugi. Po godzinie nadal nie wiesz, co ten kod robi — wiesz tylko, że nie chcesz tego dotykać.
Losowe przeglądanie plików daje dużo szczegółów i mało kontekstu. Zamiast czytać cały projekt po kolei, wybierz jedną ścieżkę: od wejścia do systemu po wynik, który widzi użytkownik.
Mit „dobrego kodu który tłumaczy się sam”
„Dobry kod jest samodokumentujący” — przydatny cel, dopóki nie próbujesz zastąpić nazwami zmiennych całej historii decyzji projektowych.
Żaden nietrywialny system nie tłumaczy się sam. Nazwa zmiennej powie Ci co zmienna przechowuje. Nie powie Ci dlaczego ta zmienna w ogóle istnieje, kto ją modyfikuje, kiedy jej wartość ma sens, ani jaki problem biznesowy wymusił jej istnienie. To kontekst, który żyje poza kodem — w decyzjach, ograniczeniach i historii zespołu.
Programiści którzy wierzą w mit samodokumentującego kodu czytają cudzy projekt jak powieść: linia po linii, plik po pliku, od góry do dołu. Po godzinie mają w głowie tysiąc szczegółów i zero zrozumienia systemu. To jest dokładnie odwrotny kierunek niż ten w którym powinieneś iść.
Czytanie cudzego kodu zaczyna się od entry points, nie od pliku który Cię zainteresował
Entry points, czyli punkty wejścia, pomagają zobaczyć, co uruchamia dany fragment kodu. Nie dają całego kontekstu, ale są dobrym początkiem śledzenia konkretnego żądania lub zadania.
Typowe entry points zależnie od typu projektu:
- Web backend: definicje routes/endpoints — to one przyjmują żądania z zewnątrz
- CLI: funkcja
main()lub odpowiednik w danym języku - Worker/scheduler: definicje zadań cyklicznych lub konsumerów kolejek
- Frontend: root component aplikacji (App.jsx, main.ts) i routing
- Biblioteka: publiczne API w pliku index.* lub w manifeście pakietu
Otwierasz entry point i zadajesz jedno pytanie: „Co ten system robi z zewnętrznego punktu widzenia?” Nie jak to robi. Co. Dopiero gdy masz tę odpowiedź, masz prawo schodzić głębiej.
Mapowanie systemu zanim zrozumiesz funkcję
Zanim utkniesz w szczegółach funkcji, sprawdź, kto ją wywołuje i z jakimi danymi. Łatwiej zrozumieć jej warunki i wyjątki, gdy znasz rolę w większym przepływie.
Otwierasz funkcję processOrder(). Ma 200 linii, 12 zmiennych, 4 zagnieżdżone if-y. Zaczynasz czytać od góry. Po 5 minutach gubisz wątek. Wracasz na początek. Po 15 minutach nadal nie wiesz, co ta funkcja robi.
Zamiast tego zrób coś przeciwnego. Zamknij plik i znajdź wszystkie miejsca, które wywołują processOrder(). Każde z tych miejsc to specyfikacja — pokazuje, z jakimi danymi wejściowymi funkcja jest wywoływana, w jakim stanie systemu, po co. Trzy callsity dadzą Ci więcej kontekstu niż czytanie ciała funkcji przez godzinę.
To podejście top-down: od kontekstu do szczegółu. Gdy poznasz przepływ, wróć do implementacji i sprawdź, czy zachowuje się tak, jak zakładają wywołujący.
Wyszukiwanie tekstu i nawigacja po symbolach: grep, rg, LSP
Większość programistów nawiguje po kodzie wyłącznie przez kliknięcie w IDE. To jest jak czytanie biblioteki przewracając każdą stronę po kolei. Działa, ale jest zbędnie powolne.
grep — twój pierwszy odruch
Zanim cokolwiek otworzysz, sprawdź czy szukany termin w ogóle istnieje i ile razy się pojawia:
# Liczba linii zawierających "processOrder" w każdym pliku JS
grep -r "processOrder" . --include="*.js" -c

# Wszystkie definicje funkcji zawierających "Order"
grep -rn "function.*Order\|def.*Order" .

# Pliki które importują dany moduł
grep -rln "from.*OrderService" .
Do szybkiego rozpoznania przydają się flagi -n (numery linii), -l (same nazwy plików), -c (liczba pasujących linii w każdym pliku) i --include (filtr nazw plików w GNU grep). Wynik wyszukiwania tekstowego może obejmować komentarze i różne symbole o tej samej nazwie.
ripgrep (rg) — grep dla nowoczesnych projektów
ripgrep domyślnie uwzględnia reguły ignorowania, m.in. .gitignore, oraz pomija pliki ukryte i binarne. Katalogi takie jak node_modules zostaną pominięte, jeśli obejmują je odpowiednie reguły — nie z powodu samej nazwy.
rg "processOrder" --type js
rg -A 5 "class OrderService"  # 5 linii kontekstu po dopasowaniu
LSP w IDE — gdy potrzebujesz semantyki
„Find References”, „Go to Definition” i „Find Implementations” korzystają z analizy języka, więc pomagają odróżnić symbole o tych samych nazwach. Wynik zależy jednak od poprawnej konfiguracji projektu i możliwości serwera językowego. Dynamiczne wywołania, generowany kod czy refleksja mogą wymagać sprawdzenia w runtime.
Używaj wyszukiwania tekstowego do szerokiego rozpoznania, a nawigacji semantycznej do śledzenia konkretnego symbolu. Kolejność dobierz do pytania i stanu indeksu projektu.
Git jako narzędzie do czytania, nie tylko commitowania
Cudzy kod to nie tylko obecny stan plików. To również historia decyzji, którą widzisz przez git log i git blame.
Kiedy widzisz dziwną linię kodu która „wygląda na bug” — zanim to zgłosisz albo naprawisz, sprawdź dlaczego ona tam jest:
# Kto i kiedy napisał konkretną linię
git blame -L 45,55 path/to/file.js

# Historia konkretnej funkcji (śledzenie zmian)
git log -L :processOrder:path/to/file.js

# Wszystkie commity dotykające pliku z opisami
git log --follow -p path/to/file.js
„Dziwna linia” może być poprawką wcześniejszego błędu. Opis commitu, powiązany ticket i test regresji pomagają ustalić powód jej istnienia. Sam git blame pokazuje ostatnią zmianę linii, nie pełną historię decyzji.
Kiedy przestać czytać i uruchomić
Statyczne czytanie kodu ma swój sufit. Powyżej pewnej złożoności żaden umysł nie utrzyma w pamięci wszystkich stanów które kod może osiągnąć. W tym momencie czytanie przestaje być produktywne.
Rozwiązanie: uruchom kod. Ale nie byle jak.
- Postaw breakpoint w entry point i debuggerem przejdź przez prawdziwe żądanie
- Dodaj tymczasowe logi w 3-4 strategicznych miejscach żeby zobaczyć kolejność wywołań
- Uruchom istniejące testy z verbose flagą — pokażą Ci jak kod się zachowuje w różnych scenariuszach
- Jeśli kod korzysta z bazy danych, sprawdź wygenerowane zapytania w query logu lub logach ORM.
EXPLAIN ANALYZEsłuży do analizy wykonania wybranego zapytania i faktycznie je uruchamia — używaj go świadomie, w odpowiednim środowisku.
Pięć minut z działającym debuggerem da Ci więcej zrozumienia niż godzina wpatrywania się w pliki. To samo podejście opisałem w artykule o stawianiu hipotez podczas debugowania — debugger jest narzędziem dedukcji, nie tylko narzędziem do łapania błędów.
Możesz dostać projekt napisany w stylu, którego nienawidzisz: globalne zmienne, funkcje na 500 linii, nazwy w transliteracji z innego języka. To nie zmienia procesu. Entry points, callsites, narzędzia, git history, uruchomienie — działa niezależnie od jakości kodu który czytasz.
Przy okazji zobacz, czy wspólne moduły grupują tę samą wiedzę, czy tylko podobne linijki. To rozróżnienie opisuję w tekście o DRY i koszcie przedwczesnej abstrakcji. Pomaga ocenić, które zależności warto poznać przed zmianą.
Faktycznie, czytanie kodu który Cię irytuje stylem to najlepszy trening tej umiejętności. Łatwo czytać kod, który wygląda jak Twój własny. Profesjonalizm zaczyna się tam gdzie kod jest brzydki, a Ty i tak musisz go zrozumieć.
Co zrobić inaczej od dziś
Następnym razem gdy dostaniesz nowy projekt — albo wrócisz do swojego własnego sprzed dwóch lat — zanim otworzysz pierwszy plik, zrób trzy rzeczy:
- Otwórz README i manifest pakietu. Zidentyfikuj typ projektu i jego entry points.
- Znajdź entry points fizycznie w kodzie. Przeczytaj tylko je — nie funkcje które wywołują.
- Wybierz jedną ścieżkę wykonania (np. jeden endpoint) i prześledź ją top-down, używając grep i LSP jako mapy.
Czytanie cudzego kodu to umiejętność, która nie ma sufitu. Im więcej kodu przeczytasz w tej strukturze, tym szybciej rozpoznajesz wzorce architektoniczne — i tym mniej czasu potrzebujesz na każdy kolejny projekt. To jest jedna z niewielu umiejętności w programowaniu, w której doświadczenie naprawdę kumuluje.
Weryfikacja techniczna: ripgrep: filtrowanie plików.