Limit CPU i pamięci bez kontenera
Jeśli potrzebujesz tylko ograniczyć zasoby zaufanego workera, nie musisz od razu pakować go do obrazu Dockera. cgroups v2 pozwala grupować procesy, mierzyć ich zużycie zasobów i nakładać limity. Na systemie z systemd często wystarczy systemd-run.
To kontrola zasobów, nie pełny sandbox. Same cgroups nie oddzielają systemu plików ani sieci i nie zastępują kontroli uprawnień. Kontenery łączą kilka mechanizmów; ich konfiguracja nie musi zawsze obejmować OverlayFS i osobnej sieci.
cgroups v2: jedna hierarchia zamiast drzew per kontroler
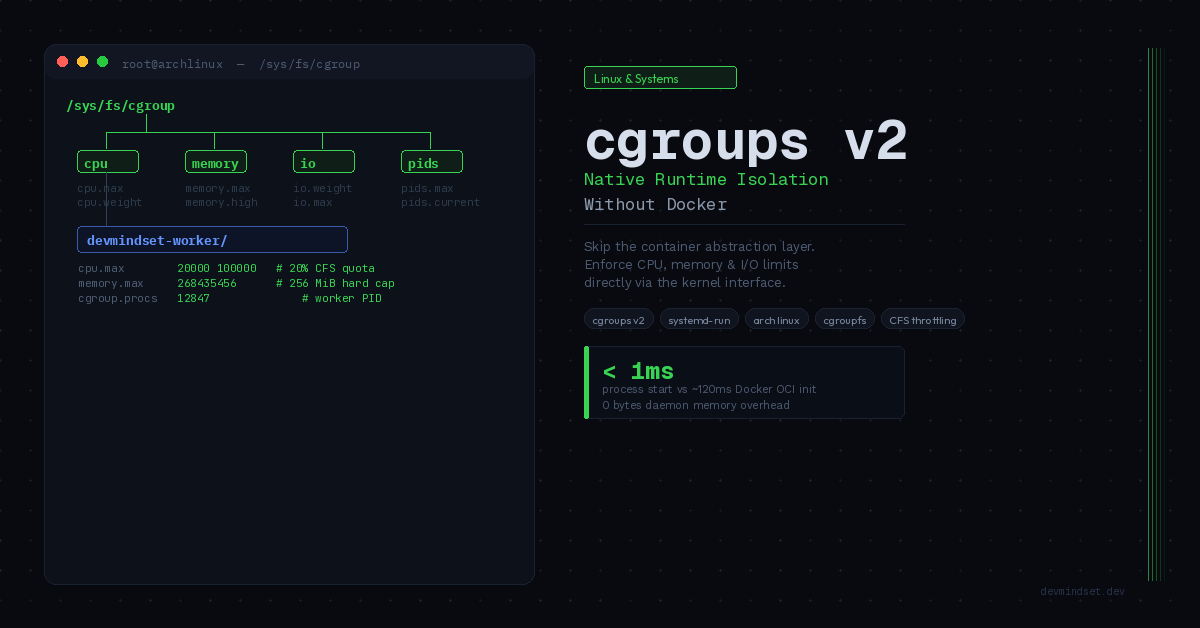
W cgroups v1 kontrolery mogły korzystać z różnych hierarchii. W v2 działają we wspólnym drzewie. W zwykłym modelu domenowym proces należy do jednej cgrupy w tej hierarchii, a dzieci dziedziczą przynależność. Tryb threaded ma dodatkowe reguły, których ten przykład nie używa.
Sprawdź montowanie i dostępne kontrolery
mount | grep cgroup
cat /sys/fs/cgroup/cgroup.controllers
cgroup2 potwierdza montowanie v2. Samo jego występowanie nie dowodzi, że w systemie nie działa też v1. Lista kontrolerów zależy od kernela i konfiguracji; w podgrupie znaczenie ma również to, co udostępnił rodzic.
Bezpośrednie zarządzanie cgroupfs
Utworzenie katalogu tworzy cgrupę. Zapis PID do cgroup.procs przenosi proces, a pliki kontrolerów przyjmują limity. Trzeba jednak zachować reguły hierarchii i mieć prawo zarządzać daną podgałęzią. Na hoście zarządzanym przez systemd nie twórz przypadkowych grup obok jego jednostek.
Kontrolery włączasz u rodzica
Poniższy fragment zakłada istniejącą, delegowaną ci, pustą grupę nadrzędną z dostępnymi kontrolerami cpu i memory. Podstaw jej rzeczywistą ścieżkę. Przykład pokazuje konfigurację, nie wykonuje kompletnego cyklu uruchomienia workera.
# CGROUP_PARENT musi wskazywać przydzieloną ci podgałąź.
: "${CGROUP_PARENT:?Ustaw sciezke delegowanej pustej cgrupy}"
printf '+cpu +memory\n' > "$CGROUP_PARENT/cgroup.subtree_control"
mkdir "$CGROUP_PARENT/devmindset-worker"
printf '20000 100000\n' > "$CGROUP_PARENT/devmindset-worker/cpu.max"
printf '268435456\n' > "$CGROUP_PARENT/devmindset-worker/memory.max"
cgroup.subtree_control udostępnia kontrolery dzieciom. Nie włączaj ich w grupie roboczej, do której chcesz przypisać procesy: dla kontrolerów domenowych obowiązuje zasada no internal processes, z wyjątkami opisanymi w dokumentacji kernela.
cpu.max przyjmuje quota i period w mikrosekundach. 20000 100000 daje grupie łącznie budżet odpowiadający 20% jednego CPU, a nie osobny limit dla każdego procesu. memory.max ustawia twardą granicę pamięci rozliczanej przez kontroler; nieudane odzyskiwanie pamięci może doprowadzić do OOM wewnątrz grupy.
Uruchomienie procesu, a dopiero potem przeniesienie jego PID zostawia okno, w którym działa poza limitem i może utworzyć potomków. Do typowego uruchamiania zadań wygodniej wykorzystać manager usług.
systemd-run: jednostka tymczasowa z limitami
Przykład używa managera użytkownika. Wymaga działającej sesji systemd i udostępnionych jej kontrolerów. Ścieżkę workera zastąp istniejącym plikiem; menedżer systemowy wymaga osobnego ustalenia uprawnień i użytkownika usługi.
systemd-run --user --wait --pipe --collect \
  --unit=devmindset-worker \
  --property=Type=exec \
  --property=CPUQuota=20% \
  --property=MemoryMax=256M \
  /usr/bin/python3 /opt/workers/pipeline_runner.py

# W drugim terminalu, podczas pracy jednostki:
systemctl --user status devmindset-worker.service
systemctl --user show devmindset-worker.service -p ControlGroup
Domyślnie powstaje transient service — nie potrzebujesz opcji --service. --scope wybiera inny model, w którym polecenie uruchamia systemd-run i dziedziczy ono środowisko wywołującego. --wait czeka na koniec usługi, --pipe przekazuje standardowe strumienie, a --collect pozwala posprzątać jednostkę po zakończeniu.
IOWeight możesz dodać, gdy chcesz ustalić względny udział w I/O. Nie jest limitem bajtów na sekundę; efekt zależy od kontrolera i stosu urządzenia. Nie dodawaj tej właściwości tylko dlatego, że występowała w gotowym przykładzie.
Uruchamianie z Pythona
Nie musisz pisać własnego kontrolera cgroupfs, żeby uruchamiać kolejne zadania z limitami. Python może wywołać ten sam manager. Lista argumentów eliminuje potrzebę składania polecenia shella, a unikalna nazwa odróżnia równoległe jednostki.
import subprocess
from pathlib import Path
from uuid import uuid4

def run_worker(script: Path) -> None:
    script = script.resolve(strict=True)
    subprocess.run([
        "systemd-run", "--user", "--wait", "--pipe", "--collect",
        "--expand-environment=no",
        f"--unit=devmindset-worker-{uuid4().hex}",
        "--property=Type=exec",
        "--property=CPUQuota=20%",
        "--property=MemoryMax=256M",
        "/usr/bin/python3", str(script),
    ], check=True)

if __name__ == "__main__":
    run_worker(Path("/opt/workers/cpu_intensive_task.py"))
--expand-environment=no wymaga systemd 254 lub nowszego i wyłącza rozwijanie zmiennych w argumentach przez systemd. Kod zakłada zaufaną ścieżkę skryptu i interpreter w podanej lokalizacji. Błąd managera lub zadania trafia do wywołującego przez CalledProcessError. To nie jest izolacja niezaufanego kodu.
Co wybierasz: limity czy środowisko kontenera?
| Potrzeba | Mechanizm do rozważenia |
|---|---|
| Limit CPU i pamięci zaufanego workera | cgroups v2, np. przez jednostkę systemd |
| Pakowanie aplikacji z zależnościami w obrazie | Narzędzia kontenerowe |
| Oddzielny widok plików, procesów lub sieci | Namespaces i odpowiednia konfiguracja uprawnień; cgroups to tylko część rozwiązania |
| Uruchamianie niezaufanego programu | Osobny projekt izolacji i model zagrożeń |
Nie ma potrzeby dopisywać uniwersalnej tabeli milisekund i megabajtów. Porównuj rozwiązania przy tych samych wymaganiach. Bezpośrednie limity mogą uprościć uruchomienie workera, ale nie zapewniają wszystkich właściwości kontenera.
Dobierz mechanizm do problemu
Jeśli problem brzmi „ten proces zabiera za dużo CPU”, zacznij od limitu i pomiaru. Jeśli brzmi „muszę dostarczyć aplikację z zależnościami i oddzielić jej środowisko”, sama cgrupa nie wystarczy. Znajomość mechanizmów kernela pozwala ustalić, czego potrzebujesz w konkretnym przypadku.
Przynależność potomków do grupy łatwiej zrozumieć, znając działanie fork(). Jeśli obserwujesz wzrost zużycia pamięci, sprawdź też różnicę między zwolnieniem alokacji a spadkiem RSS.
Weryfikacja techniczna: hierarchia i kontrolery cgroups v2, systemd-run, limity zasobów systemd.