Dlaczego RSS twojego procesu rośnie i nie spada
Program alokuje pamięć, przetwarza dane i wywołuje free(), a RSS w htop pozostaje wysoki. Sam ten objaw nie rozstrzyga, czy masz wyciek. Allocator może zachować zwolnione bloki do ponownego użycia; trzeba odróżnić je od pamięci, której program wciąż nie zwolnił.
free() w zdecydowanej większości przypadków nie oddaje pamięci systemowi operacyjnemu. Oddaje ją z powrotem do allocatora — warstwy pośredniej między twoim kodem a kernelem, która zarządza pulami pamięci, by uniknąć kosztownych syscalli przy każdej alokacji. Zrozumienie tej warstwy to różnica między „mamy memory leak” a „to fragmentacja areny, RSS się nie zmniejszy, ale to nie wyciek”.
Ten artykuł rozkłada wnętrzności malloc w glibc: areny, biny, chunki, granicę brk vs mmap, mechanikę fragmentacji oraz — kluczowe dla decyzji produkcyjnych — kiedy jemalloc lub tcmalloc bije domyślny allocator glibc.
Warstwa pośrednia: dlaczego nie wołamy kernela bezpośrednio
Kernel zarządza pamięcią w granularności stron (zwykle 4 KB). Gdyby każde malloc(16) wymagało syscalla do kernela, koszt byłby absurdalny — każdy syscall ma narzut, a typowy program robi miliony alokacji. Allocator rozwiązuje to, prosząc kernel o pamięć hurtowo i rozdzielając ją na drobne kawałki w userspace.
Dwa syscalle dostarczają pamięć od kernela:
| Mechanizm | Działanie | Użycie w glibc malloc |
|---|---|---|
brk / sbrk | Przesuwa granicę segmentu danych (program break) | Główna arena; rozmiar żądania nie wyznacza sztywnej granicy |
mmap | Mapuje anonimowe strony w dowolnym miejscu przestrzeni adresowej | Osobne duże alokacje i pamięć dodatkowych aren |
# Zobacz oba mechanizmy w akcji — strace na prostym programie
$ strace -e trace=brk,mmap ./program 2>&1 | head
brk(NULL)                = 0x55a3c2a00000        # bieżący program break
brk(0x55a3c2a21000)      = 0x55a3c2a21000        # rozszerzenie areny (132 KB)
mmap(NULL, 2101248, PROT_READ|PROT_WRITE, ...)   # duża alokacja (2 MB)
                         = 0x7f3a8c000000
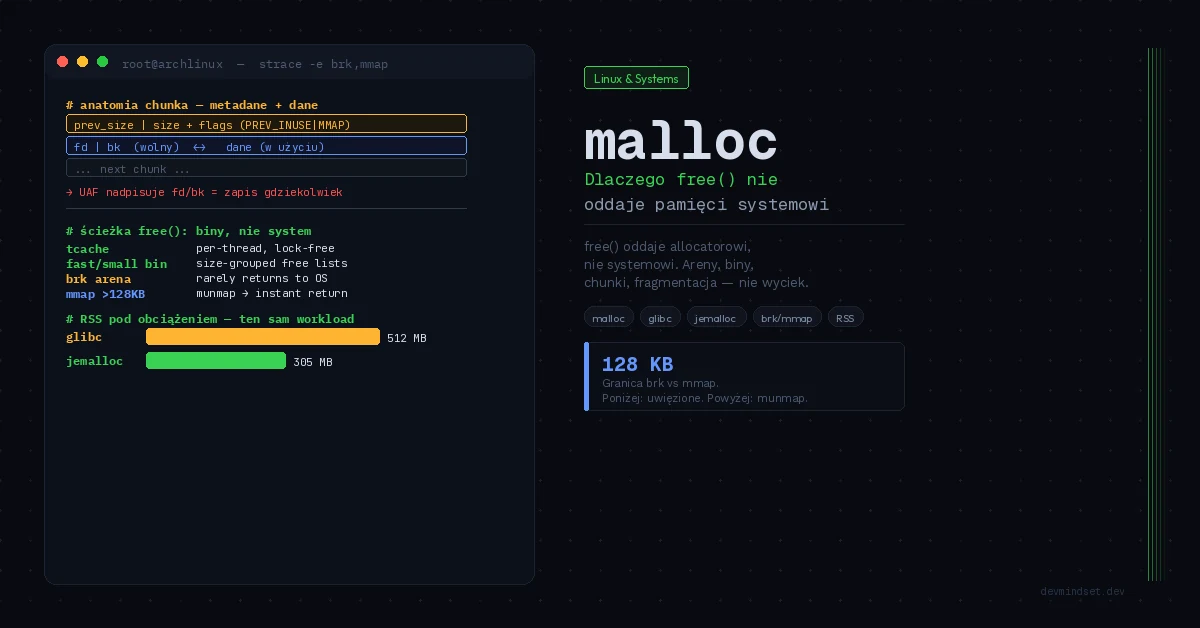
M_MMAP_THRESHOLD wpływa na wybór osobnego mapowania dla dużych alokacji. W glibc początkowy próg wynosi zwykle 128 KiB, ale może być dostrajany dynamicznie. Dostępne wolne bloki i konfiguracja też mają znaczenie — nie jest to sztywna granica dla każdego malloc().
Anatomia chunka — jak malloc pamięta rozmiary
Gdy wołasz malloc(100), dostajesz wskaźnik do 100 bajtów — ale allocator zarezerwował więcej. Każdy blok pamięci to chunk z nagłówkiem metadanych tuż przed zwróconym wskaźnikiem:
/* Uproszczona struktura chunka w glibc (ptmalloc2) */
struct malloc_chunk {
    size_t      prev_size;  /* rozmiar poprzedniego chunka, JEŚLI wolny */
    size_t      size;       /* rozmiar tego chunka + 3 bity flag */

    /* Poniższe pola używane TYLKO gdy chunk jest wolny: */
    struct malloc_chunk *fd;  /* forward pointer w liście wolnych */
    struct malloc_chunk *bk;  /* backward pointer w liście wolnych */
};

/* Trzy najniższe bity pola 'size' to flagi (wyrównanie chunków zależy od ABI): */
/* PREV_INUSE  (0x1) — czy poprzedni chunk jest w użyciu          */
/* IS_MMAPPED  (0x2) — czy chunk pochodzi z mmap (nie z areny)    */
/* NON_MAIN_ARENA (0x4) — czy chunk należy do areny wątku         */
Gdy chunk jest zajęty, część obszaru używanego później na wskaźniki list służy danym użytkownika. Dlatego zapis po free() może uszkodzić metadane allocatora. Konkretne konsekwencje zależą od wersji glibc i zabezpieczeń — nie każdy taki zapis daje kontrolowany zapis pod dowolny adres.
Biny — struktura zarządzania wolnymi chunkami
Zwolnione chunki nie są od razu oddawane systemowi. Trafiają do binów — list wolnych chunków pogrupowanych według rozmiaru, by kolejne malloc() mogło szybko znaleźć pasujący blok. glibc utrzymuje kilka kategorii binów o różnej charakterystyce:
| Typ binu | Rozmiar chunków | Charakterystyka |
|---|---|---|
| Fast bins | Małe chunki; zakres zależy od ABI i konfiguracji | LIFO, brak scalania — najszybsze, single-linked |
| Tcache | Cache wątku; zakres zależy od wersji i ustawień | Per-wątek cache (glibc 2.26+), bez locka |
| Small bins | Klasy małych rozmiarów zależne od ABI | FIFO, dokładny rozmiar, double-linked |
| Large bins | Większe klasy rozmiarów zależne od ABI | Posortowane, zakresy rozmiarów, best-fit |
| Unsorted bin | dowolny | Bufor pośredni przed klasyfikacją |
Tcache (thread-local caching) to najważniejsza optymalizacja ostatnich lat: każdy wątek ma własną pulę ostatnio zwolnionych chunków, dostępną bez zakładania locka areny. To dramatycznie przyspiesza wielowątkowe alokacje, ale wprowadziło też nowe wektory ataku (tcache poisoning).
Dlaczego free() nie oddaje pamięci
Ścieżka free() zależy od chunka i stanu allocatora. Pasujący blok może trafić do tcache lub fast binu. Inne bloki mogą zostać scalone i trafić do unsorted binu przed późniejszą klasyfikacją — to rozgałęzienia, nie sekwencja wykonywana dla każdego bloku. Odzyskiwalna pamięć może pozwolić na zmniejszenie sterty, a jawne malloc_trim() próbuje także oddać całe wolne strony.
Żywy chunk za wolnym obszarem może uniemożliwić cofnięcie brk. To nie jedyna droga odzyskania RAM-u: malloc_trim() w glibc może też oddać pełne wolne strony z wnętrza aren przez madvise(). Zachowany zakres adresów wirtualnych i rezydentna pamięć fizyczna to różne rzeczy.
#include <stdlib.h>
#include <malloc.h>

int main(void) {
    /* Alokuj 1000 bloków po 1 KB */
    void *blocks[1000];
    for (int i = 0; i < 1000; i++)
        blocks[i] = malloc(1024);

    /* Zwolnij wszystkie PARZYSTE — szachownica fragmentacji */
    for (int i = 0; i < 1000; i += 2)
        free(blocks[i]);

    /* To ilustracja przeplatanych bloków, nie benchmark RSS.
       Strony nie są jawnie dotykane; obserwowany RSS może się różnić. */

    /* Jawne wymuszenie zwrotu pamięci do systemu */
    malloc_trim(0);   /* spróbuj oddać wolne strony; wynik zależy od układu bloków */

    return 0;
}
mmap vs brk — dlaczego duże alokacje są inne
Jeśli allocator obsłuży alokację osobnym mmap(), free() może usunąć całe mapowanie przez munmap(). Nie utożsamiaj jednak dużego rozmiaru żądania z gwarancją osobnego mapowania ani dodatkowej areny z pojedynczą alokacją.
| Cecha | brk arena (małe) | Osobne mapowanie mmap |
|---|---|---|
| Zwrot do OS przy free() | Zależnie od układu wolnych bloków i stron | Natychmiast (munmap) |
| Koszt alokacji | Niski (zwykle bez syscalla) | Wysoki (syscall + page fault) |
| Fragmentacja | Możliwa (współdzielona arena) | Brak fragmentacji wspólnej areny; pozostaje zaokrąglenie do stron |
| Inicjalizacja | Pamięć może zawierać śmieci | Świeże strony anonimowe są zerowane; malloc nie gwarantuje zer dla użytkownika |
Stąd kontrintuicyjny efekt: program robiący wiele dużych alokacji może mieć stabilniejszy RSS niż program z milionem małych, bo duże wracają do systemu natychmiast, a małe zostają uwięzione w arenie. Threshold jest też dynamiczny — glibc go zwiększa, gdy wykryje, że program zwalnia duże bloki, by uniknąć kosztownych mmap/munmap cykli.
Areny — skalowanie wielowątkowe
W programie wielowątkowym, gdyby wszystkie wątki konkurowały o jedną arenę, lock na niej byłby wąskim gardłem. glibc rozwiązuje to przez multiple arenas: główna arena (na brk) plus dodatkowe areny wątków (na mmap), każda z własnym lockiem.
# Eksperyment z limitem aren — porównaj RSS i throughput:
MALLOC_ARENA_MAX=2 ./program

# Statystyki glibc wymagają wywołania funkcji w programie:
# #include <malloc.h>
# malloc_stats();     /* zapis na stderr */
# malloc_info(0, stdout); /* XML; potrzebne także <stdio.h> */
Trade-off jest bezpośredni: więcej aren = mniej kontencji locków, ale więcej zafragmentowanej, nieoddanej pamięci (każda arena trzyma własne wolne chunki). Dla aplikacji z wieloma wątkami i wrażliwych na RSS, MALLOC_ARENA_MAX=2 to częsty pierwszy strzał optymalizacyjny. To wyjaśnia też, dlaczego ten sam program zużywa więcej pamięci na maszynie 64-rdzeniowej niż 4-rdzeniowej.
Alternatywne allocatory — pomiar, nie ideologia
Poniższe kierunki porównania nie są rankingiem. Wyniki zależą od wersji allocatora, rozmiarów obiektów, liczby wątków i czasu życia alokacji.
Domyślny ptmalloc2 w glibc to kompromis ogólnego przeznaczenia. Dla konkretnych workloadów wyspecjalizowane allocatory dają mierzalną przewagę.
| Allocator | Mocna strona | Typowe zastosowanie |
|---|---|---|
| ptmalloc2 (glibc) | Uniwersalny, zawsze dostępny | Domyślny, większość aplikacji |
| jemalloc | Niska fragmentacja, przewidywalny RSS, profiling | Bazy danych, długo żyjące serwery (Redis, FB) |
| tcmalloc (Google) | Bardzo szybkie małe alokacje, świetne wielowątkowo | Aplikacje Google, intensywne alokacje |
| mimalloc (Microsoft) | Allocator nastawiony na wydajność i ograniczanie fragmentacji | Nowe projekty, .NET runtime |
# Ten sam program i dane; ścieżka do jemalloc zależy od dystrybucji.
/usr/bin/time -v ./serwer
/usr/bin/time -v env LD_PRELOAD=/usr/lib/libjemalloc.so.2 ./serwer

# Porównaj Maximum resident set size, ale również czas i opóźnienia.
# Powtórz pomiary i zamień kolejność uruchomień.
# Alternatywnie linkuj program z jemalloc przy kompilacji:
gcc program.c -ljemalloc -o program
Podmiana przez LD_PRELOAD wykorzystuje interpozycję symboli — jej ograniczenia opisuje artykuł o ELF i dynamic linking. Porównuj allocatory na tym samym workloadzie, z tym samym czasem rozgrzewki. Pojedynczy spadek RSS nie rozstrzyga o opóźnieniach ani przepustowości.
Diagnostyka — narzędzia
| Narzędzie | Zastosowanie |
|---|---|
strace -e brk,mmap | Które syscalle pamięci program faktycznie wykonuje |
malloc_stats() | Statystyki aren i binów glibc na wyjściu |
malloc_info() | Programistyczny zrzut stanu allocatora (XML) |
valgrind --tool=massif | Profil zużycia sterty w czasie (heap profiler) |
jemalloc + jeprof | Profiling alokacji z atrybucją do funkcji |
/proc/<pid>/smaps | Szczegółowy podział RSS na mapowania (heap, mmap, anon) |
cat /proc/<pid>/status | VmRSS vs VmData — rezydentna vs zarezerwowana |
Podsumowanie: allocator jako warstwa, którą trzeba rozumieć
malloc i free to nie cienkie wrappery na kernel — to wyrafinowana warstwa zarządzania pamięcią z arenami, binami, chunkami i strategiami przeciwdziałania fragmentacji. Inżynier rozumiejący tę warstwę nie panikuje na widok wysokiego RSS po free(), wie kiedy to fragmentacja a kiedy realny wyciek, i potrafi świadomie dobrać allocator do charakterystyki workloadu.
Przy diagnozie zestaw RSS, mapowania procesu i profil żywych alokacji. Dopiero taki obraz pozwala rozdzielić cache allocatora, fragmentację i wyciek.
free() kończy prawo programu do używania bloku, ale nie obiecuje spadku RSS. Sprawdź, kto nadal posiada pamięć i które strony allocator może oddać.
Powiązane artykuły
- Anatomia segfaulta — od MMU przez kernel po core dump w gdb — use-after-free i korupcja chunków od strony page faultów
- ELF i dynamic linking — co dzieje się zanim odpali main() — LD_PRELOAD jako mechanizm podmiany allocatora
- mmap — kiedy memory-mapped I/O bije read() i write() — mmap dla dużych alokacji anonimowych
- fork() Linux — co naprawdę robi pod spodem — copy-on-write i współdzielenie stron sterty
Weryfikacja techniczna: mallopt(3), malloc_trim(3), malloc_stats(3).