awk to nie one-liner do wycinania kolumn
Znasz awk '{print $2}' do wyciągania drugiej kolumny? To dobry początek, ale tylko mały fragment języka. awk ma własny model wykonania, tablice asocjacyjne, funkcje i kontrolę przepływu. Przy filtrowaniu i agregowaniu tekstu często wystarczy jeden krótki program.
Nazwa pochodzi od nazwisk twórców: Aho, Weinbergera i Kernighana. Najciekawszy pozostaje model pracy — program dopisujesz do gotowej pętli czytającej rekordy, zamiast za każdym razem pisać ją od zera.
Przejdziemy przez rekordy i pola, bloki BEGIN/END, tablice i prostą maszynę stanową. Potem zostaje decyzja: kiedy wystarczy przenośne awk, kiedy potrzebujesz rozszerzeń gawk, a kiedy wygodniejszy będzie Python.
Model wykonania: rekord, pole, wzorzec-akcja
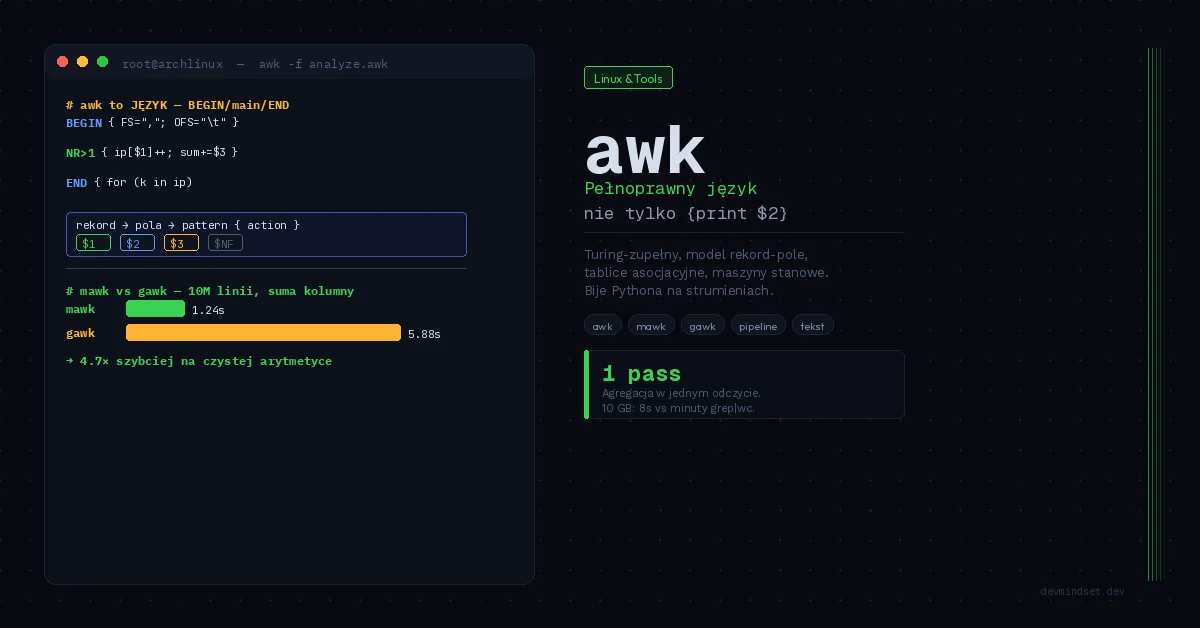
Fundament awk to cykl przetwarzania, który większość użytkowników wykonuje nieświadomie. awk czyta wejście rekord po rekordzie (domyślnie linia = rekord), dzieli każdy rekord na pola (domyślnie po białych znakach) i dla każdego rekordu sprawdza zestaw reguł wzorzec → akcja.
# Struktura programu awk: seria reguł pattern { action }
pattern1 { action1 }
pattern2 { action2 }

# Jeśli wzorzec pasuje do bieżącego rekordu → wykonaj akcję
# Brak wzorca → akcja dla każdego rekordu
# Brak akcji → domyślnie { print $0 } (cały rekord)
Zmienne wbudowane definiują kontekst każdego rekordu:
| Zmienna | Znaczenie |
|---|---|
$0 | Cały bieżący rekord |
$1, $2, ... $NF | Poszczególne pola (od 1, nie od 0) |
NF | Number of Fields — liczba pól w rekordzie |
NR | Number of Records — numer bieżącego rekordu (globalnie) |
FNR | Numer rekordu w bieżącym pliku (resetuje się między plikami) |
FS | Field Separator — separator pól (domyślnie biały znak) |
OFS | Output Field Separator — separator przy print |
RS | Record Separator — separator rekordów (domyślnie newline) |
Bloki BEGIN i END
Dwa specjalne wzorce zmieniają awk z filtra w pełny program. BEGIN wykonuje się raz przed pierwszym rekordem, END raz po ostatnim. To pozwala na inicjalizację stanu i agregację wyników:
FS="," w przykładzie obsługuje prosty tekst rozdzielony przecinkami. Nie parsuje pełnego CSV z przecinkami, cudzysłowami lub nowymi liniami wewnątrz pól. Do takich danych użyj parsera CSV, np. trybu gawk --csv w wersji, która go obsługuje.
# Suma i średnia trzeciej kolumny — pełny program, nie one-liner
BEGIN {
    FS = ","           # separator: przecinek (CSV)
    OFS = "\t"         # output: tab
    print "Przetwarzanie..."
}

# Główna pętla — wykonuje się dla każdego rekordu
NR > 1 {              # pomiń nagłówek (rekord 1)
    sum += $3
    count++
}

# Wykonuje się raz, po przetworzeniu całości
END {
    if (count > 0)
        printf "Suma: %.2f | Średnia: %.2f | Rekordów: %d\n", \
               sum, sum / count, count
}
Tablice asocjacyjne — gdzie awk pokazuje pazury
Tablice w awk są zawsze asocjacyjne (hash maps) — indeksowane dowolnym stringiem, nie tylko liczbą. To czyni awk naturalnym narzędziem do grupowania, zliczania i deduplikacji bez żadnych zewnętrznych struktur danych.
# Zliczanie wystąpień IP w logu Apache — klasyczny problem produkcyjny
# Wejście: standardowy access.log (IP w pierwszym polu)

{
    ip_count[$1]++       # tablica indeksowana adresem IP
}

END {
    # Iteracja po kluczach tablicy asocjacyjnej
    for (ip in ip_count) {
        print ip_count[ip], ip
    }
}

# Użycie z sortowaniem top 10:
# awk -f count_ips.awk access.log | sort -rn | head -10
Zliczanie tablicą pozwala przejść przez log raz i posortować dopiero zagregowany wynik. Kosztem jest pamięć na unikalne adresy IP; przy bardzo dużej liczbie kluczy to ograniczenie może być ważniejsze od zwięzłości kodu.
Deduplikacja zachowująca kolejność
Problem, którego sort -u nie rozwiąże, bo niszczy kolejność. awk robi to trywialnie:
# Usuń duplikaty, zachowaj pierwszą kolejność wystąpienia
# (sort -u zmieniłby kolejność — to inny rezultat)

!seen[$0]++

# Mechanika: seen[$0] to 0 (false) przy pierwszym wystąpieniu,
# !0 = true → linia drukowana. Post-inkrementacja czyni ją >0,
# więc !seen[$0] = false przy kolejnych → linia pomijana.
To idiomatyczny awk: jedna linia, zero zewnętrznych zależności, single pass. Wyrażenie !seen[$0]++ to wzorzec bez akcji — domyślna akcja { print $0 } wykonuje się tylko gdy wzorzec jest prawdziwy.
awk jako maszyna stanowa
Tu awk przekracza granicę „narzędzia tekstowego” i staje się pełnym językiem. Range patterns (/start/,/end/) i zmienne stanu pozwalają parsować strukturalne formaty — sekcje, bloki, zagnieżdżenia.
# Parser sekcji w pliku konfiguracyjnym (format INI)
# Ekstrakcja wszystkich kluczy z konkretnej sekcji [database]

BEGIN { in_section = 0 }

# Wykrycie nagłówka sekcji
/^\[.*\]$/ {
    # Usuń nawiasy, porównaj nazwę sekcji
    section = substr($0, 2, length($0) - 2)
    in_section = (section == "database") ? 1 : 0
    next        # przejdź do następnego rekordu
}

# Wewnątrz docelowej sekcji i linia to klucz=wartość
in_section && /=/ {
    pos = index($0, "=")
    kv[1] = substr($0, 1, pos - 1)
    kv[2] = substr($0, pos + 1)
    gsub(/^[ \t]+|[ \t]+$/, "", kv[1])   # trim klucza
    gsub(/^[ \t]+|[ \t]+$/, "", kv[2])   # trim wartości
    config[kv[1]] = kv[2]
}

END {
    for (key in config)
        printf "%-20s = %s\n", key, config[key]
}
To przykład maszyny stanowej dla prostego podzbioru INI. Śledzi sekcję i zbiera pary klucz–wartość, ale nie definiuje całej składni komentarzy, escape’ów ani wielowierszowych wartości. Do plików o bogatszej składni wybierz parser zgodny z ich formatem.
Funkcje zdefiniowane przez użytkownika
awk wspiera własne funkcje z rekurencją i lokalnym zakresem — kolejny dowód, że to pełny język:
# Funkcja rekurencyjna: silnia (przykład rekurencji)
function factorial(n) {
    return (n <= 1) ? 1 : n * factorial(n - 1)
}

# Funkcja z parametrami lokalnymi (konwencja: dodatkowe params = locals)
function trim(str,    result) {     # 'result' to zmienna lokalna
    result = str
    gsub(/^[ \t\r\n]+|[ \t\r\n]+$/, "", result)
    return result
}

BEGIN {
    print factorial(10)              # 3628800
    print "[" trim("  hello  ") "]"  # [hello]
}
Uwaga na konwencję: awk nie ma jawnych zmiennych lokalnych. Idiom to dodatkowe parametry funkcji (po wcięciu dla czytelności) — są inicjalizowane na pusty string i działają jako lokalne. To jedyny sposób na uniknięcie zanieczyszczenia globalnego zakresu.
mawk vs gawk vs busybox awk — pomiar, nie ideologia
Istnieje kilka implementacji awk o fundamentalnie różnej charakterystyce wydajnościowej. Wybór ma realne konsekwencje produkcyjne.
| Implementacja | Charakterystyka | Co sprawdzić |
|---|---|---|
| mawk | Kompaktowa implementacja z kodem pośrednim | Czas na własnym skrypcie i danych |
| gawk (GNU) | Najbogatsza: rozszerzenia, Unicode, networking, debugger | Potrzebne rozszerzenia i koszt ich użycia |
| busybox awk | Wbudowana w systemy embedded, minimalna | Zestaw funkcji w konkretnym buildzie |
| goawk | Implementacja w Go, dobra na CSV, przenośna | Zgodność skryptu i pomiar na tych samych danych |
# Porównaj ten sam skrypt, dane, locale i stan cache.
LC_ALL=C time mawk '{s+=$1} END{print s}' bignum.txt
LC_ALL=C time gawk '{s+=$1} END{print s}' bignum.txt

# Powtórz pomiary w zmienionej kolejności i sprawdź zgodność wyników.
# Ustal, co faktycznie uruchamiasz:
command -v awk
awk --version  # opcja zależy od implementacji; gawk ją obsługuje
Reguła praktyczna: mawk do prostego, masowego przetwarzania (sumowanie, filtrowanie, zliczanie na gigabajtowych strumieniach), gawk gdy potrzebujesz Unicode, tablic zagnieżdżonych, gensub(), sortowania wbudowanego (asort) lub innych rozszerzeń GNU. Na Debianie domyślny awk to często mawk — co oznacza, że skrypty używające rozszerzeń gawk mogą zakończyć się błędem lub działać inaczej.
awk vs Python — kiedy co
| Scenariusz | Wybór |
|---|---|
| Filtrowanie/sumowanie kolumn na strumieniu >1 GB | awk (mawk) — single pass, minimalny narzut |
Pipeline w shellu (część cmd | awk | cmd) | awk — natywny obywatel uniksowego pipeline |
| Prosta agregacja/grupowanie w jednym przejściu | awk — tablice asocjacyjne za darmo |
| Logika >50 linii, wiele struktur danych | Python — czytelność, testowalność |
| Parsowanie JSON/XML/formatów zagnieżdżonych | Python — awk nie ma natywnego parsera |
| Integracja z API, bazami, zewnętrznymi bibliotekami | Python — ekosystem |
| Jednorazowa transformacja w terminalu | awk — zero boilerplate, zero importów |
| Kod produkcyjny wymagający testów jednostkowych | Python — awk trudno testować |
Granica jest klarowna: awk wygrywa na strumieniach tabularycznych w pipeline, gdzie liczy się przepustowość i zwięzłość. Python wygrywa, gdy logika rośnie, dochodzą struktury zagnieżdżone albo kod ma żyć długo i być utrzymywany. Sięganie po Pythona do print $2 to over-engineering; pisanie parsera JSON w awk to inżynierski masochizm.
Praktyczny przykład: analiza logów w jednym przejściu
# Analiza access.log: status codes i transfer total
# Jeden pass przez plik, wiele agregacji jednocześnie

BEGIN {
    OFS = "\t"
}

{
    # Pole 9 = status HTTP, pole 1 = IP, pole 10 = bajty
    status[$9]++
    ip_hits[$1]++
    total_bytes += ($10 ~ /^[0-9]+$/) ? $10 : 0

    if ($9 >= 500) errors_5xx++
    if ($9 >= 400 && $9 < 500) errors_4xx++
}

END {
    print "=== Status Codes ==="
    for (code in status)
        print code, status[code]

    print "\n=== Transfer ==="
    printf "Total: %.2f MB\n", total_bytes / 1024 / 1024
    printf "4xx: %d | 5xx: %d\n", errors_4xx, errors_5xx

    print "\n=== Rekordów przetworzonych ==="
    print NR
}
Program zbiera kilka agregatów podczas jednego odczytu. Zakłada układ pól access loga pokazany w komentarzu; nie jest parserem dowolnego formatu logów. Wersja z raportem najczęstszych IP jest w repozytorium przykładów i wymaga GNU awk, m.in. ze względu na PROCINFO["sorted_in"].
Podsumowanie: awk jako precyzyjne narzędzie, nie relikt
W awk pętla nad rekordami jest częścią języka. Kiedy dane i reguły pasują do tego modelu, agregacja mieści się w kilku czytelnych liniach. Gdy rośnie liczba wyjątków lub potrzebujesz bibliotek, przelicz koszt utrzymania skryptu.
Zanim wybierzesz narzędzie, sprawdź format danych i liczbę unikalnych kluczy. Potem porównaj wyniki oraz czas — sama wielkość pliku nie wyznacza zwycięzcy.
Powiązane artykuły
- Start Basha i koszt konfiguracji .bashrc
- Czytanie cudzego kodu i szukanie punktów wejścia
- Debugowanie na podstawie hipotez
Weryfikacja techniczna: GNU awk — CSV, POSIX awk.