Po co mapować plik zamiast czytać go przez read()
Klasyczny odczyt pliku to open() i pętla read() kopiująca dane do bufora. Część baz danych, linkerów i innych programów wybiera mmap(): mapuje plik w przestrzeni adresowej i korzysta z niego przez dostęp do pamięci. To jeden z modeli I/O, a nie wspólna strategia wszystkich baz danych.
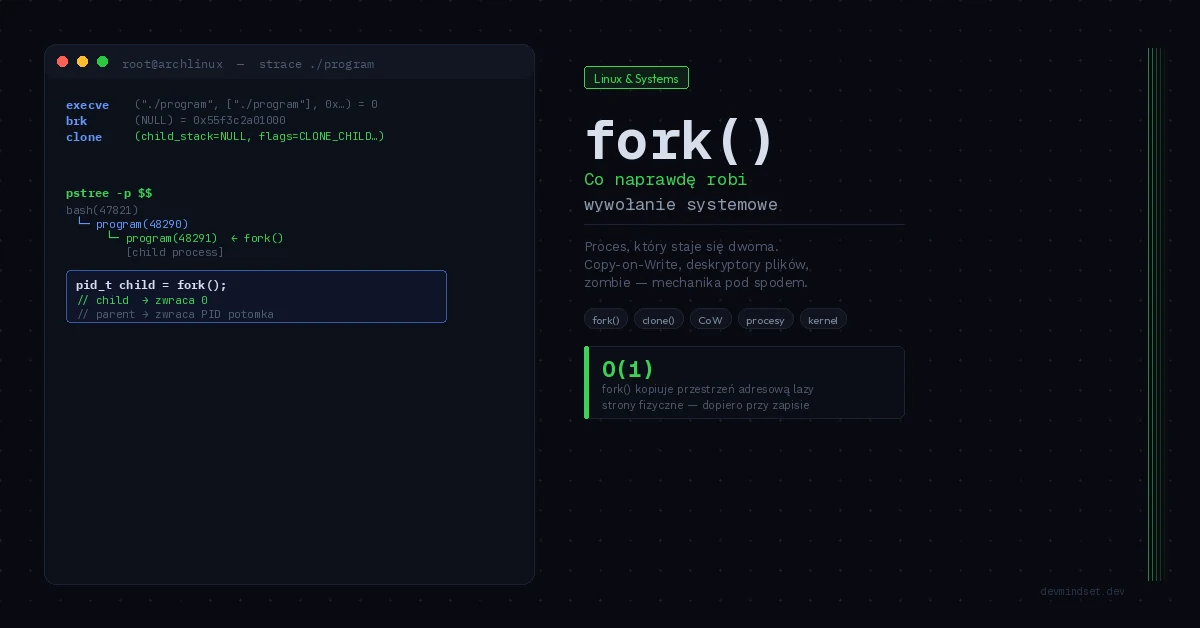
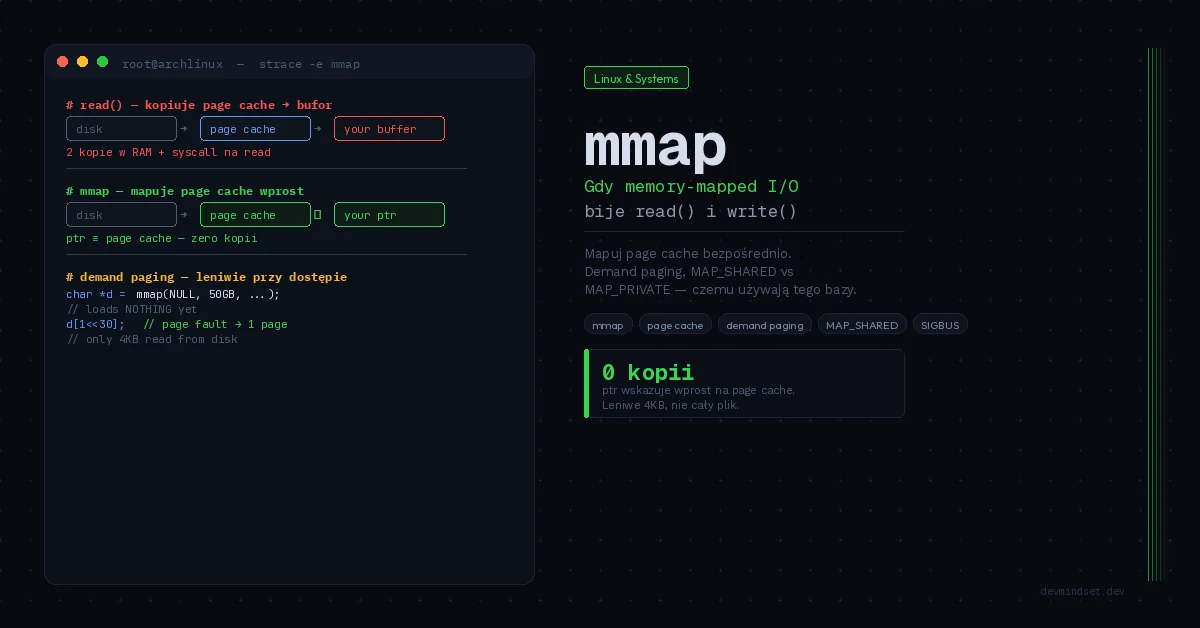
Różnica nie jest kosmetyczna. read() wykonuje syscall i kopiuje dane z page cache do twojego bufora — dwie kopie tego samego bajtu w RAM. mmap eliminuje tę kopię: twój wskaźnik wskazuje bezpośrednio na strony page cache, a kernel ładuje je leniwie (demand paging) dopiero przy faktycznym dostępie. Dla pliku 50 GB, z którego czytasz losowe fragmenty, to różnica fundamentalna.
Ten artykuł rozkłada mmap: mechanikę demand paging, różnicę MAP_SHARED vs MAP_PRIVATE, relację z page cache, oraz — równie ważne — kiedy mmap jest pułapką: małe pliki, random writes, ryzyko SIGBUS przy truncacji.
Czym jest mmap — mapowanie zamiast kopiowania
mmap (memory map) to syscall tworzący nowe mapowanie w wirtualnej przestrzeni adresowej procesu. Mapowanie może wskazywać na plik (file-backed) lub na anonimową pamięć (anonymous — właśnie tego używa allocator glibc dla dużych alokacji). Po zmapowaniu pliku, dostęp do pamięci jest tłumaczony przez MMU na dostęp do odpowiednich fragmentów pliku.
#include <sys/mman.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <unistd.h>
#include <stdio.h>

int main(void) {
    int fd = open("/data/large.bin", O_RDONLY);
    if (fd < 0) { perror("open"); return 1; }

    struct stat st;
    if (fstat(fd, &st) == -1) { perror("fstat"); close(fd); return 1; }
    if (st.st_size <= 0) { close(fd); return 0; }                    // potrzebujemy rozmiaru pliku

    /* Mapuj cały plik do przestrzeni adresowej — bez kopiowania */
    unsigned char *data = mmap(
        NULL,                          // kernel wybiera adres
        st.st_size,                    // rozmiar mapowania
        PROT_READ,                     // tylko odczyt
        MAP_PRIVATE,                   // prywatna kopia-przy-zapisie
        fd,
        0                              // offset w pliku
    );
    if (data == MAP_FAILED) { perror("mmap"); close(fd); return 1; }

    close(fd);   // fd można zamknąć — mapowanie pozostaje ważne

    /* Czytaj plik jak zwykłą tablicę — kernel ładuje strony leniwie */
    printf("Pierwszy bajt: 0x%02x\n", data[0]);
    if (st.st_size > 1024L * 1024 * 1024) printf("Bajt na 1 GB: 0x%02x\n", data[1024L * 1024 * 1024]);
    // Brak mapowania strony może wywołać fault; dane mogą już być w cache.

    munmap(data, st.st_size);          // zwolnij mapowanie
    return 0;
}
Po mmap() można zamknąć deskryptor — mapowanie trzyma własną referencję. Późniejszy dostęp może wywołać page fault obsługiwany przez kernel. Sam fault nie oznacza błędu programu; rozróżnienie rozwijam w anatomii segfaulta.
Demand paging — leniwe ładowanie
Przy zwykłym mapowaniu bez flag wymuszających wcześniejsze ładowanie mmap() ustala zakres i uprawnienia. Strony oraz ich wpisy w tablicach stron mogą być dołączane dopiero przy dostępie. Page fault może skorzystać z istniejącego page cache albo wymagać I/O; readahead może pobrać więcej danych niż strona, której właśnie dotknąłeś.
# Zobacz demand paging w akcji — minor vs major page faults
$ /usr/bin/time -v ./mmap_program 2>&1 | grep -i fault
    Major (requiring I/O) page faults: 1247    # strony wczytane z dysku
    Minor (reclaiming a frame) page faults: 89 # strony już w page cache

# Porównaj liczbę syscalli read/mmap; strace nie zlicza page faultów
$ strace -c -e trace=read,mmap ./read_version  2>&1 | tail -5
$ strace -c -e trace=mmap ./mmap_version 2>&1 | tail -5
Przy losowym dostępie nie musisz wczytywać całego pliku. mmap() pozwala odwoływać się do wybranych zakresów, a pread() oferuje odczyt z podanego offsetu bez osobnego lseek(). Rzeczywista ilość I/O zależy od cache, readaheadu i wzorca dostępu.
MAP_SHARED vs MAP_PRIVATE — fundamentalna różnica
Flaga trybu mapowania determinuje co dzieje się przy zapisie i czy zmiany są widoczne dla innych procesów. To rozróżnienie jest źródłem zarówno mocy, jak i subtelnych bugów.
| Aspekt | MAP_SHARED | MAP_PRIVATE |
|---|---|---|
| Zapis trafia do pliku | Tak (przez page cache) | Nie (copy-on-write) |
| Widoczność dla innych procesów | Tak — współdzielone strony | Nie — prywatna kopia po zapisie |
| Mechanizm przy zapisie | Strona oznaczona dirty, writeback | CoW — kopia strony dla zapisującego |
| Zastosowanie | IPC, pamięć współdzielona, zapis do pliku | Ładowanie kodu (.text), read-only dane |
MAP_SHARED udostępnia zmiany procesom mapującym ten sam obszar. Nadal potrzebujesz synchronizacji dostępu, np. muteksa współdzielonego między procesami; widoczność zmian nie jest też gwarancją ich trwałego zapisu na dysku. Mechanikę oczekiwania opisuje artykuł o futeksach.
MAP_PRIVATE używa copy-on-write — tego samego mechanizmu, który napędza wywołanie fork(): dopóki tylko czytasz, dzielisz strony z page cache. Pierwszy zapis do strony tworzy prywatną kopię, widoczną tylko dla twojego procesu. Tak ładowany jest segment .text każdego programu — wszystkie instancje /bin/bash współdzielą te same strony kodu, dopóki żadna ich nie modyfikuje.
Shared memory między procesami
#include <stdio.h>
#include <unistd.h>
#include <sys/wait.h>
/* Proces A — zapisuje do współdzielonego mapowania anonimowego */
#include <sys/mman.h>
#include <string.h>

int main(void) {
    /* Anonimowe MAP_SHARED — współdzielone z procesami potomnymi po fork() */
    char *shared = mmap(
        NULL, 4096,
        PROT_READ | PROT_WRITE,
        MAP_SHARED | MAP_ANONYMOUS,    // brak pliku, czysta pamięć
        -1, 0
    );

    if (shared == MAP_FAILED) { perror("mmap"); return 1; }
    pid_t pid = fork();
    if (pid == -1) { perror("fork"); munmap(shared, 4096); return 1; }
    if (pid == 0) {
        /* Dziecko widzi zapisy rodzica — te same fizyczne strony */
        strcpy(shared, "wiadomość od dziecka");
        return 0;
    }

    wait(NULL);
    printf("Rodzic czyta: %s\n", shared);   // widzi zapis dziecka
    munmap(shared, 4096);
    return 0;
}
Relacja z page cache
Tu mmap pokazuje swoją prawdziwą naturę. Gdy mapujesz plik file-backed, strony mapowania są stronami page cache — tego samego cache, którego Linux używa do buforowania zwykłych buforowanych operacji plikowych. To dlatego mmap eliminuje kopię: read() kopiuje z page cache do twojego bufora, a mmap mapuje page cache bezpośrednio w twoją przestrzeń adresową.
Jeśli dane są już w page cache, dołączenie ich do mapowania może obejść się bez odczytu z urządzenia. Ten wspólny mechanizm dla read() i mmap() rozwijam w artykule o page cache w Linuksie. Prywatne strony zmienione przez CoW mają już inny charakter niż oryginalne strony pliku.
# Sprawdź ile pliku jest w page cache (przed i po mmap)
$ vmtouch /data/large.bin
           Files: 1
     Directories: 0
  Resident Pages: 0/12800  0%      # nic w cache

$ ./mmap_program /data/large.bin   # mapuje i czyta fragmenty
$ vmtouch /data/large.bin
  Resident Pages: 3200/12800  25%  # tylko dotknięte strony w cache

# Kontrola zachowania cache przez madvise w kodzie:
# MADV_SEQUENTIAL — readahead agresywny (czytanie liniowe)
# MADV_RANDOM     — wyłącz readahead (random access)
# MADV_DONTNEED — porzuć strony mapowania; nie gwarantuje usunięcia z page cache
# MADV_WILLNEED   — prefetch (zapowiedź dostępu)
madvise() to klucz do wydajności mmap: informujesz kernel o wzorcu dostępu, a on dostosowuje readahead. Dla czytania liniowego MADV_SEQUENTIAL włącza agresywny prefetch; dla random access MADV_RANDOM wyłącza marnotrawny readahead.
Kiedy mmap jest pułapką
mmap nie jest uniwersalnie lepszy od read(). Istnieją scenariusze, w których jest wolniejszy, bardziej ryzykowny lub po prostu niewłaściwy.
| Scenariusz | Problem |
|---|---|
| Małe pliki (< kilka KB) | Narzut mmap/munmap + page fault > koszt prostego read() |
| Sekwencyjny odczyt raz | read() z buforem bywa szybszy — prostszy readahead |
| Random writes do pliku | Dirty pages + nieprzewidywalny writeback, trudna kontrola |
| Plik może być skrócony | SIGBUS przy dostępie do strony za nowym końcem pliku |
| Sieciowe systemy plików (NFS) | Semantyka spójności mmap na NFS jest problematyczna |
| Potrzeba obsługi błędów I/O | read() zwraca błąd; mmap sygnalizuje przez SIGBUS/SIGSEGV |
Najgroźniejsza pułapka to SIGBUS. Jeśli zmapujesz plik, a następnie inny proces (lub ty sam) skróci go przez truncate(), dostęp do strony za nowym końcem pliku wygeneruje SIGBUS — sygnał, który domyślnie zabija proces. W przeciwieństwie do read(), które grzecznie zwróciłoby błąd lub krótszy odczyt, mmap nie ma sposobu na „miękkie” zgłoszenie tego problemu w czasie dostępu.
Obsługa SIGBUS przez globalny sigjmp_buf nie jest uniwersalnym sposobem zabezpieczenia odczytu, zwłaszcza w programie wielowątkowym. Najpierw ustal, kto może skrócić plik, i skoordynuj jego cykl życia. Gdy potrzebujesz błędów zwracanych przez zwykłe wywołanie, rozważ pread().
mmap vs read() — decision matrix
| Scenariusz | Wybór |
|---|---|
| Random access do wielkiego pliku (>100 MB) | Porównaj mmap z pread na tych samych zakresach danych |
| Plik czytany wielokrotnie przez wiele procesów | mmap — współdzielony page cache |
| Shared memory IPC między procesami | mmap (MAP_SHARED) z uzgodnionym mechanizmem synchronizacji |
| Sekwencyjny odczyt całości raz | read() — prostszy, dobry readahead |
| Małe pliki konfiguracyjne | read() — narzut mmap się nie zwraca |
| Plik o zmiennym rozmiarze / ryzyko truncacji | read() — brak ryzyka SIGBUS |
| Streaming, pipe, socket | read() — mmap wymaga seekable fd |
| Krytyczna obsługa błędów I/O | read() — błędy jako wartość zwracana |
| Bardzo wysoki throughput I/O | Rozważ io_uring i zmierz batching oraz kolejkę operacji; nie ma uniwersalnego progu IOPS |
Diagnostyka — narzędzia
| Narzędzie | Zastosowanie |
|---|---|
cat /proc/<pid>/maps | Wszystkie mapowania procesu (file-backed i anonimowe) |
cat /proc/<pid>/smaps | Szczegóły per-mapowanie: RSS, dirty, swap, shared/private |
pmap -x <pid> | Czytelne zestawienie mapowań z rozmiarami |
vmtouch | Ile pliku jest w page cache; manualne ładowanie/zwalnianie |
/usr/bin/time -v | Major vs minor page faults programu |
strace -e mmap,munmap,madvise | Faktyczne wywołania mapowania i podpowiedzi |
perf stat -e page-faults | Profil page faultów pod obciążeniem |
Podsumowanie: mmap jako narzędzie precyzyjne
mmap to nie „szybszy read()” — to inny model dostępu do plików, który eliminuje kopiowanie przez bezpośrednie mapowanie page cache w przestrzeń adresową procesu. Dla random access do wielkich plików, współdzielenia pamięci między procesami i plików czytanych wielokrotnie, może być właściwym narzędziem. Dla małych plików, czystego streamingu i scenariuszy wymagających twardej obsługi błędów I/O — read() pozostaje właściwym wyborem.
O wyborze decyduje wzorzec dostępu i sposób obsługi błędów. Sam brak wywołań read() nie mówi, ile danych pobrano z urządzenia ani ile czasu kosztowały page faulty.
Gdy następnym razem zobaczysz bazę danych mapującą wielogigabajtowy plik zamiast czytać go przez read() — już wiesz, że to nie przypadek, tylko świadoma decyzja inżynierska oparta na demand paging i współdzielonym page cache.
W repozytorium jest eksperyment mmap kontra read w Pythonie. Jego mm.read() i wycinki tworzą obiekty bytes, więc nie jest to pomiar dostępu bez kopiowania. Metody losowe generują różne offsety, a tworzenie pliku rozgrzewa cache — traktuj wyniki jako obserwację tego skryptu, nie rozstrzygnięcie wydajności API.
Powiązane artykuły
- malloc internals — dlaczego free() nie oddaje pamięci systemowi — mmap dla dużych alokacji anonimowych i mechanika allocatora
- Anatomia segfaulta — od MMU przez kernel po core dump w gdb — page faults i mapowania w /proc/pid/maps
- epoll vs io_uring — kiedy event loop przestaje wystarczać — alternatywne modele I/O o wysokim throughput
- fork() Linux — co naprawdę robi pod spodem — copy-on-write wspólny dla MAP_PRIVATE i fork()
Weryfikacja techniczna: mmap(2), madvise(2).