
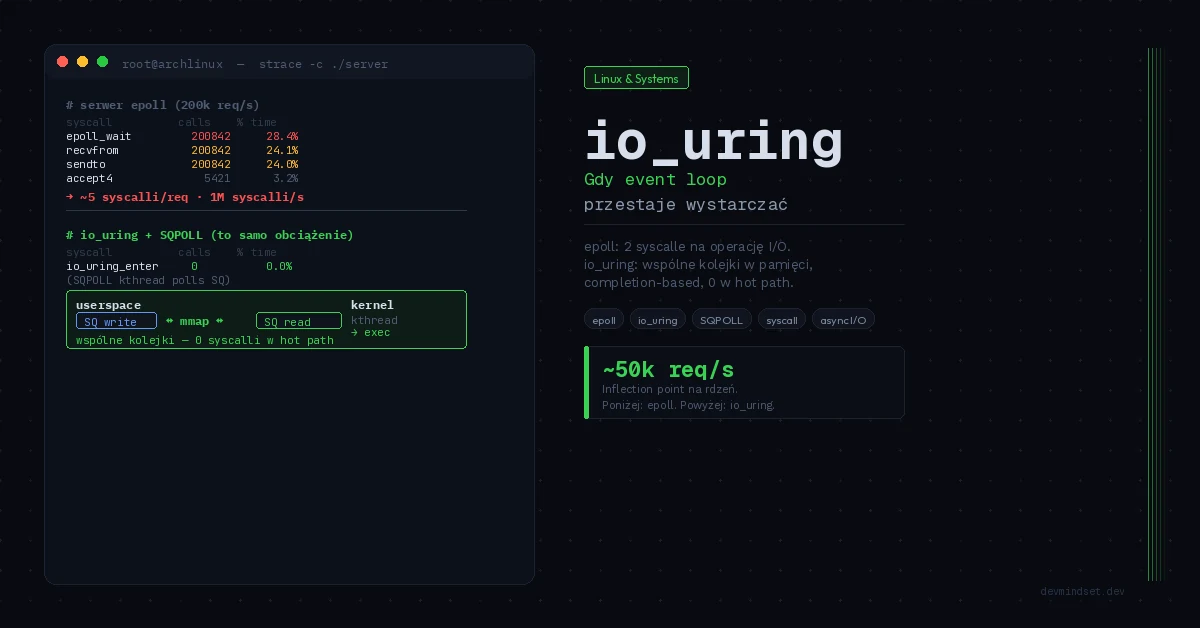
Problem skalowania I/O w userspace
Przy dużej liczbie połączeń osobny wątek dla każdego klienta może kosztować więcej, niż chcesz zapłacić. Event loop oparty na epoll pozwala czekać na wiele deskryptorów w jednym wątku. io_uring idzie inną drogą: zlecasz operację i odbierasz jej wynik. Co ta różnica zmienia w praktyce?
Potem przyszedł 2019 i kernel 5.1, a Jens Axboe wprowadził io_uring — fundamentalnie inny model asynchronicznego I/O, oparty nie na readiness notification, ale na completion notification, z dwiema współdzielonymi kolejkami między userspace a kernelem.
Porównamy model gotowości z modelem ukończenia operacji, batching i koszt obsługi kolejek. Nie ma jednego progu RPS, powyżej którego trzeba porzucić epoll — znaczenie ma to, na czym aplikacja rzeczywiście traci czas.
epoll — model oparty na gotowości (readiness-based)
Wprowadzony w kernelu 2.5.45 jako odpowiedź na ograniczenia select() i poll(), epoll to rejestr deskryptorów plików, dla których kernel powiadamia userspace, gdy są gotowe do operacji. Trzy syscalle definiują interfejs:
epoll_create1()— tworzy instancję epoll i zwraca jej fdepoll_ctl()— dodaje/usuwa/modyfikuje obserwowane fdepoll_wait()— blokuje (lub timeoutuje) aż któreś z fd staną się gotowe
Krytyczna pułapka: epoll powiadamia, ale nie wykonuje
epoll_wait() informuje, że deskryptor jest gotowy, ale nie odczytuje danych. Aplikacja wykonuje read() lub recv(). Nie oznacza to jednak dwóch syscalli na każdą operację: jedno oczekiwanie może zwrócić wiele gotowych deskryptorów, a aplikacja może wykonać wiele odczytów przed kolejnym oczekiwaniem.
import select
import socket

# Minimalny odbiornik TCP: odczytuje i odrzuca dane, nie jest serwerem echo.
server = socket.socket()
server.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
server.setblocking(False)
server.bind(("127.0.0.1", 8080))
server.listen(128)
epoll = select.epoll()
epoll.register(server.fileno(), select.EPOLLIN | select.EPOLLET)
connections = {}

def close_client(fd):
    epoll.unregister(fd)
    connections.pop(fd).close()

try:
    while True:
        for fd, event in epoll.poll():
            if fd == server.fileno():
                # Także accept trzeba wykonywać aż do EAGAIN.
                while True:
                    try:
                        client, _ = server.accept()
                    except BlockingIOError:
                        break
                    client.setblocking(False)
                    connections[client.fileno()] = client
                    epoll.register(client.fileno(), select.EPOLLIN | select.EPOLLET)
            elif fd in connections:
                try:
                    while True:
                        data = connections[fd].recv(4096)
                        if not data:  # EOF
                            close_client(fd)
                            break
                        # Tutaj przetwarzaj odebrane bajty.
                except BlockingIOError:
                    if event & (select.EPOLLERR | select.EPOLLHUP):
                        close_client(fd)
                except OSError:
                    close_client(fd)
finally:
    for client in connections.values():
        client.close()
    epoll.close()
    server.close()
Przykład pokazuje odczyt w ET, bez protokołu, limitów klientów i obsługi zapisu. Serwer echo potrzebowałby również bufora niewysłanych danych oraz obsługi częściowych zapisów i EPOLLOUT. Przejście userspace → kernel nie jest tym samym co przełączenie procesu przez scheduler. Koszt zmierz w swoim środowisku, np. zaczynając od liczenia syscalli przez strace.
Edge-Triggered vs Level-Triggered
Level-triggered (LT) powiadamia o deskryptorze, dopóki warunek gotowości się utrzymuje. W edge-triggered (ET) nie możesz liczyć na ponowne powiadomienie tylko dlatego, że zostawiłeś dane w buforze. Używaj deskryptorów nieblokujących i obsługuj I/O do EAGAIN. Dotyczy to także przyjmowania połączeń. ET może ograniczyć liczbę powiadomień, ale nie gwarantuje szybszej aplikacji.
io_uring — model oparty na ukończeniu (completion-based)
io_uring nie pyta kernela „czy mogę?”. io_uring mówi kernelowi „zrób X, daj znać jak skończysz”. Mechanika opiera się na dwóch współdzielonych pierścieniowych kolejkach w pamięci, mapowanych między userspace a kernel space przez mmap():
- Submission Queue (SQ) — userspace zapisuje operacje (SQE — Submission Queue Entry)
- Completion Queue (CQ) — kernel zapisuje wyniki (CQE — Completion Queue Entry)
Wspólna pamięć wymaga właściwej synchronizacji dostępu do kolejek; liburing obsługuje te szczegóły. Interfejs kernela obejmuje io_uring_setup(), io_uring_enter() i io_uring_register(). SQPOLL może ograniczyć wywołania potrzebne do zgłaszania pracy, ale wybudzenie wątku lub oczekiwanie na wynik nadal może wymagać syscalla.
Anatomia submitowanej operacji
Przykład wymaga nagłówków i biblioteki liburing. Zapisz go jako uring-read.c, skompiluj przez cc -Wall -Wextra uring-read.c -luring -o uring-read i podaj istniejący plik jako argument. Pokazuje jedną operację; nie jest benchmarkiem batchingu. Działania w runtime nie zweryfikowano w środowisku przygotowania tekstu.
#include <liburing.h>
#include <fcntl.h>
#include <unistd.h>
#include <stdio.h>
#include <string.h>

int main(int argc, char **argv) {
    if (argc != 2) {
        fprintf(stderr, "Usage: %s FILE\n", argv[0]);
        return 1;
    }
    int fd = open(argv[1], O_RDONLY);
    if (fd < 0) { perror("open"); return 1; }
    struct io_uring ring;
    int ret = io_uring_queue_init(8, &ring, 0);
    if (ret < 0) {
        fprintf(stderr, "queue_init: %s\n", strerror(-ret));
        close(fd);
        return 1;
    }
    int status = 1;
    char buf[4096];  /* Musi pozostać ważny do ukończenia odczytu. */
    struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
    if (!sqe) { fprintf(stderr, "SQ full\n"); goto out; }
    io_uring_prep_read(sqe, fd, buf, sizeof(buf), 0);
    ret = io_uring_submit(&ring);
    if (ret != 1) {
        fprintf(stderr, "submit: %s\n", ret < 0 ? strerror(-ret) : "no submission");
        goto out;
    }
    struct io_uring_cqe *cqe;
    ret = io_uring_wait_cqe(&ring, &cqe);
    if (ret < 0) {
        fprintf(stderr, "wait_cqe: %s\n", strerror(-ret));
        goto out;
    }
    if (cqe->res < 0) {
        fprintf(stderr, "read: %s\n", strerror(-cqe->res));
    } else {
        printf("Read %d bytes\n", cqe->res);
        status = 0;
    }
    io_uring_cqe_seen(&ring, cqe);
out:
    io_uring_queue_exit(&ring);
    close(fd);
    return status;
}
Odczyt nie pojawia się tu jako osobny syscall read(). Kernel wykonuje zleconą operację, a wynik trafia do CQ. Jeden io_uring_enter() może zgłosić wiele przygotowanych operacji, w granicach pojemności kolejki. Batching amortyzuje koszt wywołania, ale przygotowanie i obsługa wpisów nadal kosztują.
SQPOLL — eliminacja syscall z hot path
IORING_SETUP_SQPOLL uruchamia wątek kernela odczytujący submission queue. Gdy jest aktywny, może zauważyć nowe wpisy bez syscalla zgłaszającego pracę. Po okresie bezczynności zasypia i wymaga wybudzenia; oczekiwanie na ukończenie też może wejść do kernela.
Polling zużywa CPU. Od Linuksa 5.13 samo SQPOLL nie wymaga specjalnych uprawnień; wcześniej obowiązywały dodatkowe ograniczenia. Osobno sprawdź politykę bezpieczeństwa i dostępność io_uring w środowisku uruchomieniowym.
Batching i multishot zamiast stałej liczby syscalli
Multishot accept, dostępny od Linuksa 5.19, pozwala jednemu żądaniu generować wyniki dla kolejnych połączeń. W liburing służy do tego io_uring_prep_multishot_accept(). Sprawdzaj IORING_CQE_F_MORE: brak flagi oznacza, że żądanie nie wygeneruje kolejnych wyników. To inny mechanizm niż IOSQE_BUFFER_SELECT.
Co zmierzyć przed zmianą modelu I/O
Porównuj tę samą pracę: rozmiary komunikatów, liczbę aktywnych połączeń, opóźnienia i użycie CPU. W teście plikowym kontroluj też stan page cache. Wynik z jednego workloadu nie wyznacza progu migracji dla pozostałych.
Jeśli profil wskazuje koszt zgłaszania wielu drobnych operacji lub potrzebujesz współbieżnego I/O plikowego, przygotuj próbę z io_uring. Jeśli czas znika w bazie danych, serializacji lub logice aplikacji, zmiana event loop może nie ruszyć głównego ograniczenia.
Kompatybilność i kwestie bezpieczeństwa
io_uring pojawiło się w Linuksie 5.1, ale dostępność operacji i flag zależy od wersji kernela oraz poprawek dystrybucji. Numer wersji wprowadzającej API nie jest rekomendacją do wdrożenia. Sprawdź:
- obsługę potrzebnych operacji w docelowym kernelu i liburing;
- politykę seccomp i systemowe ograniczenia io_uring;
- ścieżkę obsługi błędu lub alternatywny backend;
- wymagania innych platform — epoll również jest interfejsem linuksowym.
Nie zakładaj, że dostępność API na laptopie oznacza dostępność w kontenerze produkcyjnym. Sprawdź konfigurację konkretnego hosta i wynik inicjalizacji kolejki.
Najpierw sprawdź backend swojego runtime’u
W C i C++ liburing udostępnia pomocnicze API do kolejek. W językach z własnym runtime’em sprawdź dokumentację używanej wersji: backend sieciowy i plikowy mogą się różnić. Nie wybieraj nowego języka wyłącznie po to, żeby dostać jeden interfejs I/O.
Podsumowanie: pomiar > ideologia
Jeśli obecny backend spełnia wymagania, a I/O nie jest mierzalnym wąskim gardłem, koszt migracji może nie mieć uzasadnienia. Gdy test io_uring daje zysk, sprawdź go także pod obciążeniem, przy błędach i na docelowej konfiguracji. Sama mniejsza liczba syscalli nie gwarantuje krótszej odpowiedzi.
Inżynier który najpierw mierzy CPU profile pod produkcyjnym obciążeniem zobaczy, czy syscall overhead w ogóle pojawia się w top 10. Inżynier który od razu pisze kod na liburing, bo przeczytał o nim na Hacker News, prawdopodobnie spędzi tydzień na debugging multi-shot accept’ów dla serwisu obsługującego 800 req/s, którego nigdy nikt nie skaluje do 80k.
Premature optimization is the root of all evil — Knuth wiedział co mówił. Profilowanie przed optymalizacją to nie hasło, to inżynierska dyscyplina.
Jeśli ten poziom — konkretne syscalle i to, co dzieje się między userspace a kernelem — to Twój rejon, podobną sekcję „pod maską” ma tekst o tym, co naprawdę robi fork() w Linuksie. Wątek wydajności bez zbędnej warstwy abstrakcji ciągnie dalej materiał o cgroups v2 jako natywnym prymitywie izolacji procesów bez Dockera.
Weryfikacja techniczna: epoll(7), SQPOLL, multishot accept.
Nice write-up, thanks: