Uruchamiasz program, który przetwarza duży plik. Pierwsze wykonanie trwa kilka sekund. Odpalasz dokładnie to samo polecenie ponownie i nagle wynik pojawia się niemal natychmiast.
Kod się nie zmienił. Plik się nie zmienił. Dysk też nie stał się pięć razy szybszy.
Zmieniło się jedno: dane prawdopodobnie nie musiały już zostać odczytane z urządzenia blokowego.
Linux wykorzystał wolny RAM jako page cache.
To jeden z tych mechanizmów, które działają cały czas, ale łatwo o nim zapomnieć. Wywołujesz read(), widzisz odczyt pliku i intuicyjnie myślisz: dysk. Tymczasem zwykłe buffered I/O w Linuksie przechodzi przez page cache. Jeśli potrzebne dane już znajdują się w pamięci, kernel może obsłużyć odczyt bez ponownego pobierania ich ze storage.
Ten sam mechanizm stoi za zachowaniem read(), file-backed mmap(), readaheadem, dirty pages i writebackiem. Wyjaśnia też, dlaczego serwer z 32 GB RAM może pokazywać bardzo mało pamięci jako free, a mimo to wcale nie cierpieć na brak pamięci.
Page cache nie jest dodatkiem do filesystemu. Jest centralną częścią normalnej ścieżki I/O w Linuksie.
Co właściwie cache’uje Linux
Załóżmy, że program wykonuje:
int fd = open("database.bin", O_RDONLY);

char buf[4096];
read(fd, buf, sizeof(buf));
Na wysokim poziomie wygląda to tak:
userspace
    |
    | read()
    v
kernel
    |
    v
page cache
    |
    | cache miss
    v
filesystem / block layer
    |
    v
SSD / HDD
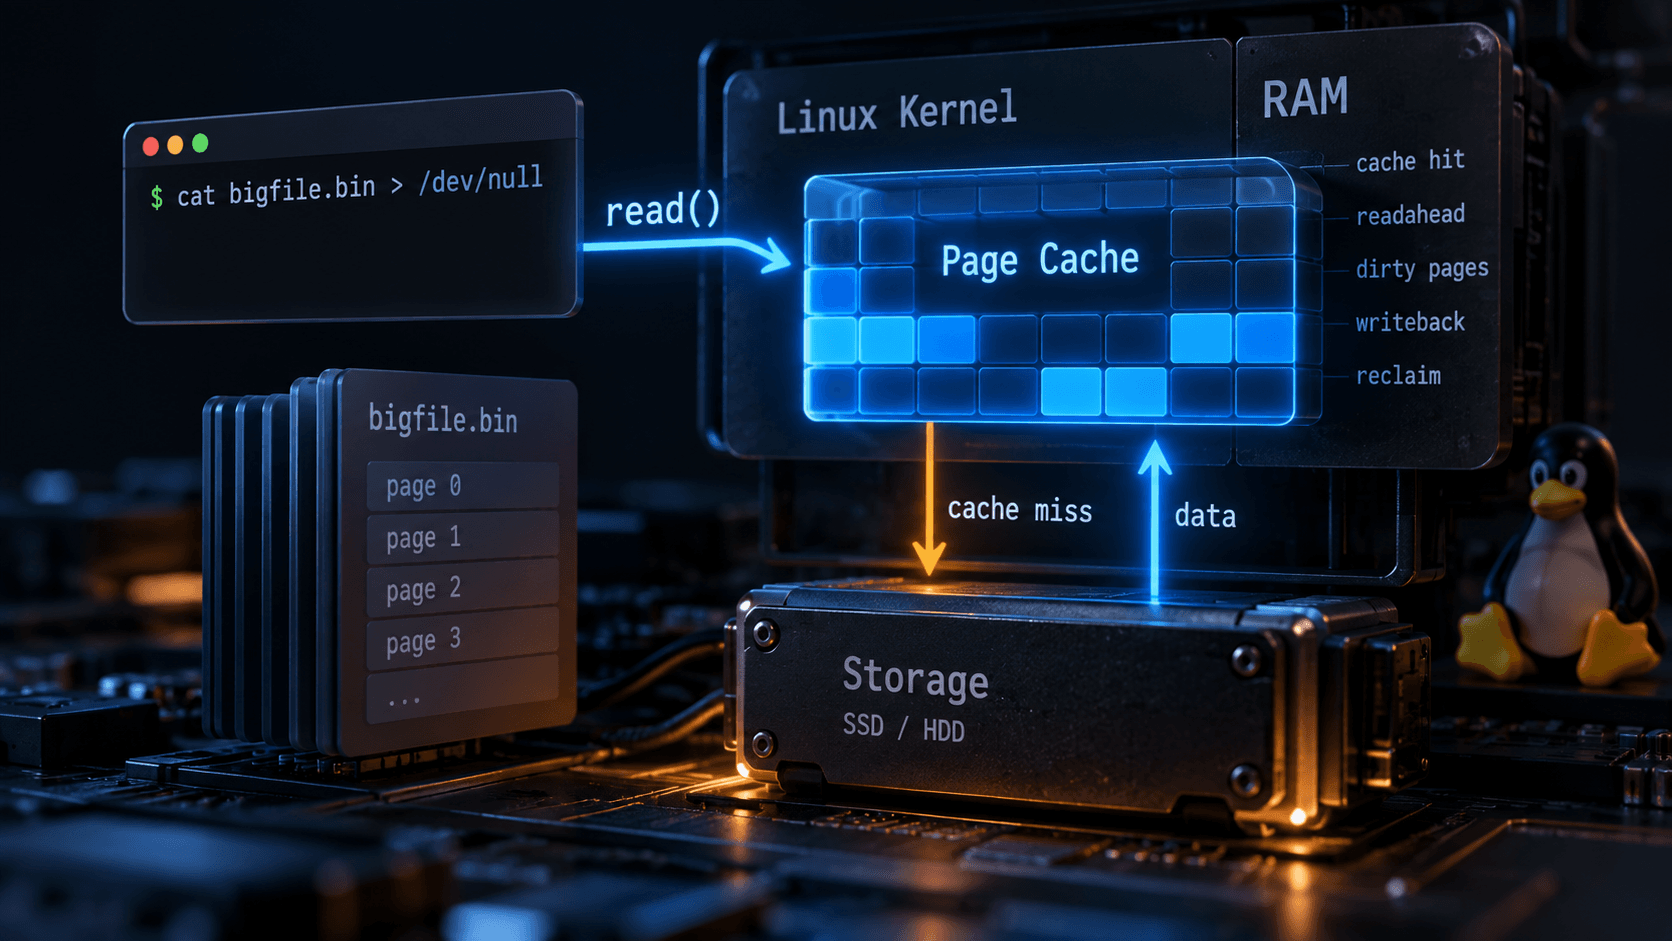
Kernel najpierw sprawdza, czy potrzebny fragment pliku jest już dostępny w page cache.
Jeśli tak, mamy cache hit. Dane można dostarczyć z RAM-u.
Jeżeli nie, następuje cache miss. Kernel musi zainicjować I/O, pobrać dane ze storage i umieścić je w page cache. Dopiero wtedy read() może skopiować je do bufora procesu.
Dlatego drugi odczyt tego samego pliku może zachowywać się zupełnie inaczej niż pierwszy:
pierwszy odczyt:

process -> read() -> page cache MISS -> storage
                                      |
                                      v
                                  page cache
                                      |
                                      v
                                   process

kolejny odczyt:

process -> read() -> page cache HIT -> process
Nie oznacza to oczywiście, że każdy drugi odczyt będzie szybszy. Dane mogły zostać wcześniej usunięte z cache, plik może być większy od dostępnej pamięci, inny workload mógł wywrzeć presję na RAM, a filesystem lub sposób otwarcia pliku może prowadzić inną ścieżką I/O.
Mechanizm jest jednak fundamentalny: normalne odczyty plików nie muszą oznaczać fizycznego odczytu z dysku.
Page cache nie jest drugim egzemplarzem całego pliku
Nazwa może sugerować wielki bufor, do którego Linux wrzuca ostatnio używane pliki w całości. Tak to nie działa.
Kernel zarządza zawartością plików w pamięci w mniejszych jednostkach. W aktualnym kodzie i dokumentacji kernela podstawową abstrakcją page cache jest folio. Folio może obejmować jedną lub więcej stron pamięci.
To istotne, bo popularne wyjaśnienie „page cache przechowuje pliki w kawałkach po 4 KB” jest przydatnym modelem na początek, ale nie jest uniwersalną prawdą o współczesnym Linuksie.
Na typowej maszynie strona bazowa często ma 4 KiB, jednak page cache nie powinien być rozumiany jako struktura na sztywno ograniczona do takich elementów.
Ważniejszy model jest prostszy: kernel potrafi przechowywać w RAM-ie konkretne zakresy zawartości pliku i ponownie wykorzystać je przy kolejnych dostępach.
Dlaczego read() nadal kopiuje dane
Page cache znajduje się po stronie kernela. Bufor przekazany do read() należy do procesu.
storage
   |
   v
page cache
   |
   | copy_to_user()
   v
userspace buffer
Gdy dane są już w cache, znika koszt dostępu do storage, ale nadal pozostaje kopiowanie danych z pamięci zarządzanej przez kernel do bufora procesu.
To jest dokładnie miejsce, w którym łączy się ten temat z wcześniejszym artykułem o mmap.
              +----------------+
              |   page cache   |
              +----------------+
                 ^          ^
                 |          |
              read()      mmap()
                 |          |
               copy      mapping
                 |          |
                 v          v
              buffer    address space
read() i file-backed mmap() nie są więc dwoma całkowicie niezależnymi światami. Oba korzystają z tej samej fundamentalnej warstwy cache plików, choć udostępniają dane procesowi w inny sposób.
Readahead — kernel czyta więcej, niż poprosiłeś
Jeżeli aplikacja czyta duży plik sekwencyjnie, kernel może rozpoznać wzorzec. Gdyby po każdym żądaniu pobierał tylko dokładnie ten fragment, na który proces aktualnie czeka, aplikacja regularnie zatrzymywałaby się na I/O.
Dlatego Linux stosuje readahead. Gdy wykryje sekwencyjny dostęp, może rozpocząć odczytywanie kolejnych fragmentów pliku zanim aplikacja jawnie o nie poprosi.
aplikacja potrzebuje:
[A]

kernel może rozpocząć:
[A][B][C][D]
   ^^^^^^^^^
    readahead
Kiedy aplikacja dochodzi do B, dane mogą już czekać w page cache. Readahead jest jednocześnie dobrym przykładem, dlaczego benchmark I/O wykonany bez kontroli warunków może prowadzić do absurdalnych wniosków. Jeśli pierwszy program czyta zimny plik, a drugi uruchamiasz chwilę później na tych samych danych, porównujesz również cold cache vs warm cache.
Random access zmienia sytuację
Readahead działa najlepiej wtedy, gdy kernel może sensownie przewidzieć przyszłe odczyty. Sekwencyjny workload jest przewidywalny, losowy znacznie mniej.
Aplikacja znająca swój workload może przekazać kernelowi wskazówkę:
posix_fadvise(fd, 0, 0, POSIX_FADV_SEQUENTIAL);
posix_fadvise(fd, 0, 0, POSIX_FADV_RANDOM);
To nie jest polecenie „musisz zrobić dokładnie to”. To advice — informacja o przewidywanym wzorcu dostępu, którą kernel może wykorzystać do optymalizacji. Istnieją również POSIX_FADV_WILLNEED, POSIX_FADV_DONTNEED i POSIX_FADV_NOREUSE.
Zapis również trafia do page cache
Page cache nie służy tylko do odczytu. Przy zwykłym buffered write dane mogą najpierw trafić do pamięci i zostać oznaczone jako dirty.
process
   |
   | write()
   v
page cache
   |
   | dirty
   v
[RAM]

... później ...

writeback
   |
   v
storage
Dirty oznacza, że zawartość w RAM-ie jest nowsza niż odpowiadająca jej zawartość na trwałym storage. To jedna z przyczyn, dla których write() może zakończyć się znacznie wcześniej, niż dane fizycznie znajdą się na urządzeniu.
Samo zakończenie write() nie jest ogólną gwarancją, że dane przetrwałyby natychmiastową utratę zasilania.
Dirty, Writeback i Cached — możesz to zobaczyć
grep -E 'MemFree|MemAvailable|Cached|Dirty|Writeback' /proc/meminfoCached pokazuje pamięć związaną m.in. z cache plików. Dirty oznacza pamięć czekającą na zapis, a Writeback dane aktualnie zapisywane.
Szczególnie ważna jest różnica między MemFree a MemAvailable. Pierwsze mówi o RAM-ie aktualnie niewykorzystywanym. Drugie próbuje oszacować, ile pamięci można wykorzystać do uruchomienia nowych aplikacji bez konieczności swapowania.
„Linux zjadł cały RAM”
Mało pamięci w kolumnie free nie oznacza automatycznie problemu. RAM, który niczego nie przechowuje, nie przyspiesza systemu. Jeśli kernel ma pamięć, której aplikacje aktualnie nie potrzebują, sensowne jest wykorzystanie jej do przechowywania danych, które mogą za chwilę zostać ponownie odczytane.
Kluczowe jest to, że czysta pamięć cache jest reclaimable. Jeżeli aplikacja potrzebuje więcej RAM-u, kernel może odzyskać pamięć zajmowaną przez dane, które nadal istnieją na backing storage.
Reclaim — kiedy cache musi ustąpić aplikacjom
Page cache nie może rosnąć bez końca kosztem wszystkiego innego. Gdy zaczyna brakować pamięci, kernel uruchamia reclaim.
Dla czystych danych file-backed sytuacja jest stosunkowo prosta: skoro identyczna zawartość nadal znajduje się na storage, kernel może przestać trzymać jej kopię w RAM-ie. Dirty data są trudniejsze — nie można ich po prostu wyrzucić, bo RAM może zawierać jedyną aktualną wersję zmian.
Page cache wykorzystuje RAM, dopóki przeznaczenie części tej pamięci na coś innego nie stanie się bardziej wartościowe.
Jak zobaczyć efekt cache bez zgadywania
dd if=/dev/urandom of=test.bin bs=1M count=1024 status=progress
/usr/bin/time -v cat test.bin > /dev/null
/usr/bin/time -v cat test.bin > /dev/null
Na systemie z wystarczającą ilością RAM drugi przebieg może być szybszy, ponieważ znaczna część danych może już znajdować się w page cache. Wynik zależy jednak od ilości RAM-u, wcześniejszej aktywności systemu, filesystemu, storage, innych procesów, rozmiaru pliku i stanu cache.
drop_caches — przydatne narzędzie, zły rytuał
sync
echo 3 | sudo tee /proc/sys/vm/drop_caches
Kernel udostępnia drop_caches, ale jest to globalna operacja wpływająca na cache systemu, a nie precyzyjny przycisk „wyczyść cache tylko mojego benchmarku”. Dokumentacja kernela ostrzega, że używanie go poza testowaniem i debugowaniem może powodować problemy wydajnościowe.
Dla konkretnego zakresu pliku bardziej precyzyjnym mechanizmem może być posix_fadvise(..., POSIX_FADV_DONTNEED), choć nadal jest to wskazówka dla kernela.
Page cache i mmap — brakujący element układanki
Przy read() dane przechodzą z pliku przez page cache i są kopiowane do bufora userspace. Przy file-backed mmap() page cache jest odwzorowany w przestrzeni adresowej procesu.
Dostęp do zmapowanego obszaru może spowodować page fault. Jeśli potrzebne dane są już rezydentne w page cache, nie musi to oznaczać odczytu ze storage. Page fault nie oznacza automatycznie disk I/O.
Czy można ominąć page cache?
Tak. Linux udostępnia między innymi O_DIRECT, które pozwala wykonywać I/O z pominięciem normalnej ścieżki page cache.
Nie oznacza to jednak, że O_DIRECT jest automatycznie szybsze. Omijając cache, aplikacja rezygnuje z warstwy ponownego wykorzystania danych i często przejmuje większą odpowiedzialność za zarządzanie I/O, wyrównanie buforów, batching oraz własną strategię cache.
Kiedy page cache pomaga, a kiedy może przeszkadzać
Page cache jest szczególnie wartościowy, gdy dane są ponownie używane. Inaczej wygląda jednorazowe skanowanie danych znacznie większych od pamięci. Taki workload może wypełniać cache danymi o niemal zerowej szansie ponownego użycia i wypierać informacje bardziej wartościowe dla pozostałych procesów.
Od Linux 6.3 POSIX_FADV_NOREUSE ma konkretne znaczenie dla algorytmu wymiany stron. To dobry przykład bardziej ogólnej zasady: cache pomaga wtedy, gdy istnieje reuse.
Page cache zmienia sposób myślenia o I/O
read() nie oznacza automatycznie dysku. Mało wolnego RAM-u nie oznacza automatycznie problemu. Zakończenie write() nie oznacza automatycznie trwałości danych. A szybszy drugi benchmark nie dowodzi automatycznie, że druga implementacja jest lepsza.
Page cache znajduje się dokładnie na granicy między światem pamięci a światem trwałego I/O. Dlatego wpływa jednocześnie na wydajność plików, zachowanie mmap, zużycie RAM-u, writeback i wiarygodność benchmarków.
Podsumowanie: wolny RAM powinien pracować
Normalne buffered reads, writes oraz file-backed mmap() korzystają z page cache. Odczyt może zostać obsłużony z RAM-u zamiast ze storage. Sekwencyjne workloady korzystają dodatkowo z readaheadu. Zapisy tworzą dirty dane, które później przechodzą przez writeback. Pod presją pamięci clean cache może zostać odzyskany, ponieważ jego zawartość nadal istnieje na backing storage.
read() nie oznacza „przeczytaj z dysku”. Oznacza „daj mi te dane”. To kernel decyduje, czy musi po nie zejść aż do storage.
Powiązane artykuły
- mmap — kiedy memory-mapped I/O bije read() i write()
- Anatomia segfaulta — od MMU przez kernel po core dump w gdb
- malloc internals — dlaczego free() nie oddaje pamięci systemowi
- epoll vs io_uring — kiedy event loop przestaje wystarczać
Źródła techniczne
- Linux Kernel Documentation — Page Cache
- Linux Kernel Documentation — Overview of the Linux Virtual File System
- Linux Kernel Documentation — memory reclaim
- Linux Kernel Documentation — /proc/sys/vm/, w tym drop_caches
- Linux man-pages — posix_fadvise(2)
- Linux man-pages — proc_meminfo(5)