Logi mówią ci, co kod myśli, że zrobił. Stack trace mówi, gdzie kod sądził, że jest. strace mówi, co kernel naprawdę zrobił — każde openat(), każde read(), każde connect(), które zwróciło -1, podczas gdy aplikacja połknęła błąd i dalej cię okłamywała. Kiedy to właśnie rozjazd między intencją a rzeczywistością jest bugiem, kolejne czytanie źródła go nie zamknie. Musisz obserwować granicę, na której kończy się userspace, a zaczyna kernel.
Większość inżynierów zna strace -p <pid> jako przycisk paniki. Mało kto faktycznie czyta output, a jeszcze mniej sięga po -f, -c czy -k, kiedy to ma znaczenie. Ta różnica decyduje, czy gapisz się w ścianę syscalli, czy potrafisz zawęzić przyczynę problemu. Traktowanie strace jako pełnoprawnego narzędzia to bezpośrednie rozwinięcie debugowania opartego na hipotezach: formułujesz precyzyjne twierdzenie o tym, co robi proces, i pozwalasz dowodom je potwierdzić albo zabić.
Więcej takich analiz znajdziesz w newsletterze DevMindset.
Co strace naprawdę obserwuje
strace używa ptrace(2) do zatrzymywania śledzonego wątku i odczytu informacji o syscallach. Zatrzymania oraz przejścia do tracera mają koszt zależny od workloadu. Szczegóły mechanizmu i uprawnień opisuje artykuł o ptrace, strace i gdb.
Czytanie linii trace’u — część, której nikt nie uczy
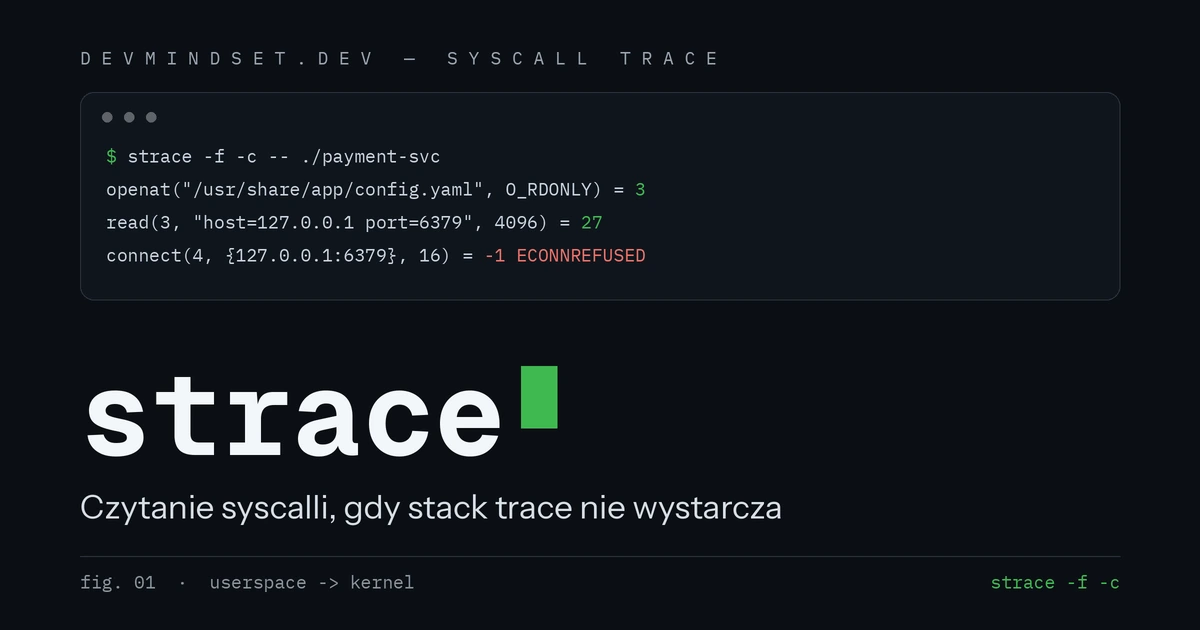
Każda linia ma ten sam kształt: syscall(argumenty) = wartość_zwracana. Prawda siedzi w wartości zwracanej. Udane wywołanie zwraca deskryptor pliku, liczbę bajtów albo 0; nieudane zwraca -1, a po nim symboliczny errno i jego opis. To właśnie ten errno jest sygnałem, po który przyszedłeś.
openat(AT_FDCWD, "/etc/app/config.yaml", O_RDONLY) = -1 ENOENT (No such file or directory)
openat(AT_FDCWD, "/usr/share/app/config.yaml", O_RDONLY) = 3
read(3, "host: 127.0.0.1\nport: 6379\n", 4096) = 27
connect(4, {sa_family=AF_INET, sin_port=htons(6379), sin_addr=inet_addr("127.0.0.1")}, 16) = -1 ECONNREFUSED (Connection refused)
EFAULT oznacza, że podany obszar pamięci nie jest dostępny dla żądanego odczytu lub zapisu. To nie test „własności” pamięci. Syscall może zwrócić błąd, podczas gdy bezpośredni nieprawidłowy dostęp instrukcją procesu może skończyć się SIGSEGV i core dumpem.
Flagi, które oddzielają sygnał od szumu
-f— podążaj za forkami i wątkami. W momencie, gdy proces woła fork() albo odpala pulę workerów, goły trace ślepnie na dzieci. Prawie każda realna usługa potrzebuje tej flagi.-e trace=…— filtruj po klasie zamiast się topić.-e trace=network,-e trace=%file,-e trace=memorytną strumień do syscalli, które cię interesują.-c— agreguj zamiast streamować. Produkuje tabelę podsumowania: czas, liczba wywołań i błędy per syscall. To twój profiler w chwili, gdy podejrzewasz, że proces jest syscall-bound.-T/-tt— czas spędzony w każdym syscallu / absolutne znaczniki czasu. Razem zamieniają „jest wolno” w „spędza 600 ms wfsync„.-y/-yy— dekoduj deskryptory, więcread(3, …)staje sięread(3</usr/share/app/config.yaml>, …), a gniazda pokazują swoje endpointy.-k— dołącz stack trace userspace’u do każdego syscalla, łącząc „który syscall” z „którą linią kodu”.-s N— zwiększ długość drukowanych stringów (domyślnie ucina payloady).
strace -c domyślnie zestawia czas CPU spędzony w kernelu, liczbę wywołań i błędy. Do czasu, który upłynął wewnątrz syscalli, służą -T lub tryb podsumowania -w -c. To różne pytania: mały czas CPU nie wyklucza długiego czekania na I/O. Przy starcie powłoki połącz taki ślad z pomiarem czasu ładowania .bashrc.
Od surowego trace’u do działającego podsumowania
Czytanie outputu -c okiem jest OK raz. Kiedy chcesz to mieć w CI, w bramce regresyjnej albo zagregowane po wielu uruchomieniach — sparsuj to. Poniższy wrapper uruchamia polecenie pod strace -f -c, zapisuje podsumowanie do osobnego pliku, parsuje je do typowanych rekordów i zwraca syscalle, które dominują czas. Obsługuje oczywiste tryby awarii — brak strace, zawieszenie procesu, zepsutą tabelę — zamiast zakładać szczęśliwą ścieżkę.
Tabela trafia do osobnego pliku przez -o, więc stderr aplikacji nie miesza się z danymi parsera. LC_ALL=C stabilizuje format liczbowy. Kod wymaga Pythona 3.10+.
from __future__ import annotations

import os
import tempfile
import shutil
import subprocess
from dataclasses import dataclass
from typing import Final

_HEADER_TOKENS: Final[tuple[str, ...]] = ("seconds", "calls", "syscall")


@dataclass(frozen=True, slots=True)
class SyscallStat:
    name: str
    seconds: float
    calls: int
    errors: int

    @property
    def usec_per_call(self) -> float:
        return (self.seconds / self.calls) * 1_000_000 if self.calls else 0.0


class StraceError(RuntimeError):
    """Podnoszony, gdy strace nie da się uruchomić lub jego podsumowania nie da się sparsować."""


def profile_syscalls(cmd: list[str], *, timeout: float = 30.0) -> list[SyscallStat]:
    """Uruchamia *cmd* pod ``strace -f -c`` i zwraca staty per syscall, od najcięższych.

    Raises:
        StraceError: brak strace, przekroczony timeout albo nie udało się
            zlokalizować tabeli podsumowania w pliku wyjściowym.
    """
    if not cmd:
        raise StraceError("puste polecenie")
    if shutil.which("strace") is None:
        raise StraceError("strace nie jest zainstalowany lub nie ma go w PATH")

    with tempfile.TemporaryDirectory(prefix="dm-strace-") as directory:
        summary = os.path.join(directory, "summary.txt")
        try:
            subprocess.run(
                ["strace", "-f", "-c", "-o", summary, "--", *cmd],
                env={**os.environ, "LC_ALL": "C"},
                timeout=timeout,
                check=False,
            )
        except subprocess.TimeoutExpired as exc:
            raise StraceError("przekroczony czas śledzenia") from exc
        except OSError as exc:
            raise StraceError("nie udało się uruchomić strace") from exc
        with open(summary, encoding="utf-8") as stream:
            return _parse_summary(stream.read())


def _parse_summary(stderr: str) -> list[SyscallStat]:
    lines = stderr.splitlines()
    header = next(
        (i for i, ln in enumerate(lines) if all(t in ln for t in _HEADER_TOKENS)),
        None,
    )
    if header is None:
        raise StraceError("nie znaleziono tabeli podsumowania; czy przekazano -c do strace?")

    stats: list[SyscallStat] = []
    for line in lines[header + 1:]:
        if not line.strip() or line.lstrip().startswith("-"):
            continue
        if "total" in line:
            break  # wiersz total kończy tabelę
        cols = line.split()
        if len(cols) < 5:
            continue
        try:
            # kolumny: %time seconds usecs/call calls [errors] syscall
            seconds = float(cols[1])
            calls = int(cols[3])
            errors = int(cols[4]) if len(cols) >= 6 and cols[4].isdigit() else 0
        except (ValueError, IndexError):
            continue  # pomiń wszystko, co nie jest wierszem danych
        stats.append(SyscallStat(name=cols[-1], seconds=seconds, calls=calls, errors=errors))

    if not stats:
        raise StraceError("tabela podsumowania jest, ale nie udało się sparsować wierszy")
    return sorted(stats, key=lambda s: s.seconds, reverse=True)


if __name__ == "__main__":
    import sys

    if len(sys.argv) < 2:
        raise SystemExit("użycie: profile.py POLECENIE [ARGUMENTY...]")

    for stat in profile_syscalls(sys.argv[1:]):
        marker = "  (są błędy)" if stat.errors else ""
        name = stat.name.ljust(18)
        calls = str(stat.calls).rjust(8)
        print(f"{name}{stat.seconds:9.4f}s {calls} wywołań  {stat.usec_per_call:8.1f} us/wyw{marker}")
Wrapper rozpoznaje brak narzędzia, timeout i brak tabeli. Parser sprawdzono na przykładowej tabeli; pełnego uruchomienia śledzenia nie zweryfikowano w środowisku przygotowania tekstu. To pomoc do lokalnego eksperymentu, nie gotowa bramka CI: trzeba jeszcze ustalić politykę kończenia całego drzewa procesów i limity danych. Wersję bashową z filtrami znajdziesz w repozytorium przykładów; jej tryb slow używa rozszerzenia match(..., ..., array) dostępnego w GNU awk.
strace vs ltrace vs gdb vs perf — wybierz właściwą soczewkę
strace to jedna soczewka, nie jedyna. Każde narzędzie obserwuje inną warstwę za inną cenę, a sięgnięcie po niewłaściwe marnuje czas albo zaburza dokładnie to zachowanie, które ścigasz.
| Narzędzie | Obserwuje | Narzut | Najlepsze pytanie | Ograniczenia operacyjne |
|---|---|---|---|---|
| strace | Syscalle (granica kernela) | Wysoki przy wielu syscallach; zależny od trybu śledzenia | O co proces prosi kernel? | Ogranicz czas śledzenia i oceń wpływ na latencję |
| ltrace | Wywołania bibliotek (userspace) | Wysoki | Które wywołania bibliotek i z jakimi argumentami? | Oceń wpływ przed podpięciem |
| gdb | Pełny stan programu, pamięć, breakpointy | Bardzo wysoki (zatrzymuje świat) | Jaki jest dokładny stan w tej linii? | Zatrzymania wpływają na usługę; analizę core wykonujesz offline |
| perf trace | Syscalle przez perf_events | Niski | Jak syscalle zachowują się pod realnym obciążeniem? | Zmierz koszt sond i zapisu danych |
| bpftrace / eBPF | Dowolne sondy w kernelu i userspace | Bardzo niski | Własne, niskonarzutowe śledzenie na produkcji | Zmierz koszt sond i zapisu danych |
Kiedy nie sięgać po strace
Attach może zostać odrzucony przez reguły ptrace, Yama, capabilities, inne LSM lub seccomp. Sam UID ani uruchomienie w kontenerze nie wyjaśniają całej polityki. Przed podpięciem do usługi ustal cel pomiaru, zakres i akceptowalny wpływ na jej pracę.
Do wszystkiego, co musi działać pod produkcyjnym obciążeniem, sięgaj po perf trace albo narzędzie eBPF w rodzaju bpftrace — obserwują tę samą granicę syscalli za ułamek kosztu. Ale na maszynie, którą kontrolujesz, z procesem, który możesz sobie pozwolić spowolnić, strace pozostaje najszybszym sposobem na odpowiedź na jedyne pytanie, które się liczy, gdy intencja rozjeżdża się z rzeczywistością: co ten proces naprawdę robi? Kiedy nauczysz się płynnie czytać jego output, to pytanie przestaje być zagadką i staje się zwykłym lookupem.
Weryfikacja techniczna: strace(1).