DRY jako kult — i jego ukryty koszt
„Don’t Repeat Yourself” łatwo sprowadzić do polowania na podobne linijki. Na code review pada: „wyciągnij to do wspólnej funkcji”. Kod robi się krótszy, ale następna zmiana wymaga flagi, wyjątku i sprawdzenia trzech niezależnych modułów. Co właściwie udało się uprościć?
Tymczasem to nie DRY zabija codebase’y. Premature abstraction zabija codebase’y. Cytując Sandi Metz: „duplication is far cheaper than the wrong abstraction” — i to zdanie powinno wisieć w każdym pokoju architektonicznym obok zasad SOLID, jako kontrapunkt.
Ten artykuł rozkłada moment, w którym pogoń za DRY przestaje być inżynierią, a staje się długiem technicznym o nieoczywistym oprocentowaniu. Pokazuje, jak rozpoznać fake duplication (przypadkową zbieżność) versus real duplication (powtórzenie tego samego konceptu domenowego) i kiedy świadomie zostawić skopiowane 30 linii w trzech miejscach.
Pierwotny kontekst DRY — i jak został wypaczony
Andy Hunt i Dave Thomas w The Pragmatic Programmer (1999) sformułowali DRY w bardzo precyzyjny sposób:
„Every piece of knowledge must have a single, unambiguous, authoritative representation within a system.”
Słowo klucz: knowledge. Nie kod. Nie składnia. Wiedza domenowa.
Jeśli tę samą regułę podatkową kopiujesz w pięciu miejscach, jej zmiana wymaga pięciu zgodnych poprawek. To problem DRY. Jeśli podobne linijki opisują różne reguły i zmieniają się niezależnie, wspólna funkcja może tylko ukryć tę różnicę.
Anatomia fałszywej abstrakcji
Rozważmy realistyczny scenariusz. System e-commerce. Trzy moduły mają funkcje walidujące dane wejściowe:
# module: user_registration.py
def validate_user_data(data: dict) -> ValidationResult:
    errors = []
    if not data.get("email"):
        errors.append("Email is required")
    if len(data.get("password", "")) < 8:
        errors.append("Password too short")
    if not data.get("terms_accepted"):
        errors.append("Terms must be accepted")
    return ValidationResult(valid=not errors, errors=errors)


# module: product_creation.py
def validate_product_data(data: dict) -> ValidationResult:
    errors = []
    if not data.get("name"):
        errors.append("Name is required")
    if data.get("price", 0) <= 0:
        errors.append("Price must be positive")
    if not data.get("category_id"):
        errors.append("Category is required")
    return ValidationResult(valid=not errors, errors=errors)


# module: order_submission.py
def validate_order_data(data: dict) -> ValidationResult:
    errors = []
    if not data.get("user_id"):
        errors.append("User is required")
    if not data.get("items"):
        errors.append("Order must contain items")
    if data.get("total", 0) <= 0:
        errors.append("Total must be positive")
    return ValidationResult(valid=not errors, errors=errors)
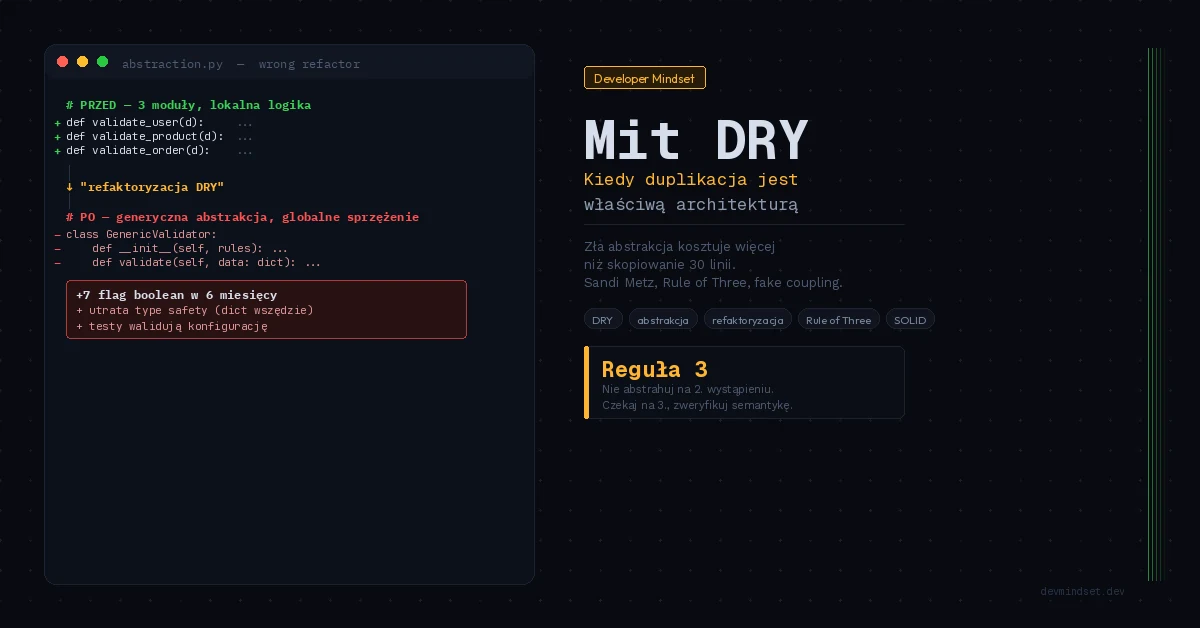
Można wyciągnąć wspólny mechanizm zbierania błędów do GenericValidator z listą reguł. Przykłady są szkicami: pomijają definicje typów wyników i klas reguł.
class GenericValidator:
    """
    Shared mechanism; domain rules remain separate.
    """

    def __init__(self, rules: list[ValidationRule]) -> None:
        self._rules = rules

    def validate(self, data: dict) -> ValidationResult:
        errors = [
            rule.error_message
            for rule in self._rules
            if not rule.check(data)
        ]
        return ValidationResult(valid=not errors, errors=errors)


# Now usage looks like:
USER_VALIDATOR = GenericValidator([
    RequiredFieldRule("email", "Email is required"),
    MinLengthRule("password", 8, "Password too short"),
    BooleanTrueRule("terms_accepted", "Terms must be accepted"),
])
Sam ten refaktoring nie dowodzi jeszcze błędu. Silnik reguł może być użyteczny. Pułapka zaczyna się wtedy, gdy dla zachowania wspólnej abstrakcji zaczynasz wciskać do niej różne polityki domenowe.
Gdzie pojawia się koszt wspólnej abstrakcji
Przy kolejnych zmianach sprawdź:
- Czy reguły nadal rozwijają się niezależnie? Osobna reguła blokowanych domen e-mail nie musi zmieniać silnika. Jeśli jednak silnik dostaje warunki „dla użytkownika zrób X, dla produktu Y”, zaczyna mieszać odpowiedzialności.
- Czy interfejs zachowuje potrzebne typy? Oba przykłady już używają
dict, więc refaktoring nie odbiera im istniejącej kontroli typów. Problem pojawiłby się przy zastąpieniu konkretnych DTO ogólnym słownikiem tylko po to, żeby dopasować je do wspólnego API. - Jak szeroki jest zasięg zmiany? Modyfikacja współdzielonego mechanizmu wymaga sprawdzenia jego klientów. Modyfikacja odrębnej reguły domenowej nie musi dotykać pozostałych walidatorów.
- Co sprawdzają testy? Niezależnie od formy implementacji powinny weryfikować zachowanie: jakie dane są akceptowane i jakie błędy wracają. Testowanie konfiguracji nie jest z definicji mniej wartościowe; niewystarczające są testy, które tylko odtwarzają jej zapis.
Cytując ponownie Sandi Metz: „prefer duplication over the wrong abstraction”. Kod przed refaktoringiem był czytelny w pojedynczym zakresie. Każda funkcja walidacyjna była samodzielna, miała pełny kontekst i można ją było zmieniać bez konsekwencji.
Reguła Three Strikes — kiedy abstrakcja jest gotowa
Reguła trzech podpowiada, żeby przy kolejnym podobnym przypadku sprawdzić, czy powtarza się już rozpoznawalny wzorzec. Daje czas na poznanie różnic między zastosowaniami.
Rule of Three jest heurystyką, nie prawem statystyki. Trzecie wystąpienie może dać więcej informacji, ale nie gwarantuje dobrej abstrakcji. Dwie kopie dobrze rozpoznanej reguły też mogą już wymagać wspólnego źródła prawdy.
Ryzyko wczesnej refaktoryzacji polega na tym, że następny przypadek pasuje tylko „prawie”. Zanim dodasz dla niego specjalną flagę, sprawdź, czy wspólna funkcja nadal opisuje jedną spójną operację.
Rosnąca lista flag jako sygnał ostrzegawczy
Klasyczny objaw zbyt wczesnej abstrakcji. Funkcja, która kiedyś robiła jedno, teraz przyjmuje rosnący zestaw flag:
def process_order(
    order: Order,
    skip_inventory_check: bool = False,
    skip_payment: bool = False,
    is_b2b: bool = False,
    is_subscription: bool = False,
    bypass_fraud_check: bool = False,
    legacy_pricing_mode: bool = False,
    use_new_tax_calculator: bool = True,
) -> OrderResult:
    # 200 lines of branching hell
    ...
Nie każda flaga oznacza błąd projektu, ale ich rosnąca liczba utrudnia zrozumienie dozwolonych wariantów. Dla n niezależnych flag istnieje 2ⁿ kombinacji wartości. To nie znaczy, że złożoność cyklomatyczna automatycznie rośnie wykładniczo ani że każda kombinacja jest osiągalną ścieżką.
Sprawdź, czy da się wydzielić operacje nazwane intencją, np. process_b2b_subscription_order() i process_one_off_consumer_order(). Wspólne kroki mogą pozostać współdzielone, bez jednego publicznego interfejsu z zestawem przełączników.
Tabela decyzyjna: DRY czy duplikacja?
| Sytuacja | Co sprawdzić |
|---|---|
| Ta sama reguła biznesowa | Czy wszystkie zastosowania mają zmieniać się razem? Jeśli tak, szukaj wspólnego źródła. |
| Podobne stałe, np. timeouty | Ta sama liczba nie musi oznaczać tej samej polityki. Nazwij intencję każdej wartości. |
| Kontrakt API | Utrzymuj jedno uzgodnione źródło kontraktu; sposób generowania klientów zależy od projektu. |
| Walidacja różnych encji | Można współdzielić mechanizm, zachowując osobne reguły domenowe. |
| Podobny kod, różne powody zmian | Pozostaw możliwość niezależnej ewolucji. |
| Kilka użyć o tej samej semantyce | Wspólna abstrakcja może zmniejszyć koszt zmian. |
Test heurystyczny: kiedy abstrakcja jest właściwa
Przed wyciągnięciem wspólnego kodu zadaj sobie cztery pytania:
- Czy oba miejsca będą zmieniały się z tego samego powodu? Jeśli nie — duplikacja jest przypadkowa, nie wyciągaj. (Single Responsibility Principle, sformułowany przez Roberta Martina jako: „a module should have one and only one reason to change”).
- Czy potrafię nazwać tę abstrakcję bez słowa „Generic”, „Common”, „Util”, „Helper”, „Base”? Jeśli nie — brakuje ci pojęcia domenowego. Nie ma abstrakcji bez nazwy oddającej intencję.
- Czy mogę zmienić jedną z duplikacji bez patrzenia na pozostałe? Jeśli tak, duplikacja kupuje ci lokalną niezależność rozumowania. To wartość, nie wada.
- Czy oba miejsca należą do tego samego kontekstu domenowego? Współdzielenie między bounded contexts wprowadza zależność. Może być świadomą decyzją, ale podobne nazwy i linijki nie wystarczą do jej uzasadnienia.
Nie zliczaj odpowiedzi mechanicznie: „tak” w trzecim pytaniu przemawia właśnie za niezależnością. Szukaj wspólnej semantyki i wspólnego powodu zmiany. Sama liczba powtórzeń tego nie rozstrzyga.
Konkretny przykład: kiedy ta sama linia kodu w dwóch miejscach jest właściwa
Poniższy szkic porównuje odpowiedzialności modułów, nie przedstawia kompletnej polityki uwierzytelniania. Walidacja wymaganych claims, wystawcy i odbiorcy musi wynikać z konkretnego kontraktu tokena.
# auth/jwt_validator.py
def validate_jwt(token: str) -> UserClaims:
    try:
        payload = jwt.decode(token, SECRET_KEY, algorithms=["HS256"])
    except jwt.ExpiredSignatureError:
        raise AuthenticationError("Token expired")
    except jwt.InvalidTokenError as exc:
        raise AuthenticationError(f"Invalid token: {exc}")
    return UserClaims(**payload)


# webhooks/signature_validator.py
def validate_webhook_jwt(token: str) -> WebhookClaims:
    try:
        payload = jwt.decode(token, WEBHOOK_SECRET, algorithms=["HS256"])
    except jwt.ExpiredSignatureError:
        raise WebhookValidationError("Webhook token expired")
    except jwt.InvalidTokenError as exc:
        raise WebhookValidationError(f"Invalid webhook token: {exc}")
    return WebhookClaims(**payload)
„Ależ to identyczny kod!” — krzyknie reviewer.
Nie. To są dwa różne konteksty bezpieczeństwa z różnymi sekretami, różnymi typami wyjątków i różnymi modelami claims. Łączenie ich w jedną funkcję validate_any_jwt(token, secret, claims_class, error_class) stworzy zależność krzyżową, którą później ktoś rozszerzy o „tylko jedną” flagę asymetrycznej kryptografii dla webhooków, a potem o „tylko jeden” custom claim dla user JWT, i za rok będzie miał funkcję z 12 parametrami.
Dwa moduły, dwa konteksty, dwie odpowiedzialności. Identyczny szkielet to tylko cecha sygnatury JWT, nie powód do sprzęgania.
Gdzie wspólne źródło wiedzy pomaga
Oddzielanie odpowiedzialności nie usprawiedliwia utrzymywania rozbieżnych kopii tej samej reguły. Wspólne źródło wiedzy przydaje się szczególnie w tych miejscach:
- Schemat bazy danych — migracje powinny jasno opisywać jego zmiany. DTO i modele domenowe nie muszą odwzorowywać tabel; automatyczne generowanie ma sens tam, gdzie faktycznie reprezentują ten sam kontrakt.
- API contracts między serwisami — OpenAPI/Protobuf/GraphQL schema jako single source of truth, oba końce generowane z tego samego pliku.
- Constants konfiguracyjne — żadnego magic stringa „production” w 47 miejscach, jedno
Environment.PRODUCTION. - Reguły wynikające z przepisów — utrzymuj jasno wskazane źródło dla konkretnej reguły i jej wersji. Różne kraje, okresy obowiązywania i konteksty mogą wymagać różnych reguł.
To są przypadki real knowledge duplication — naruszenie pierwotnej definicji DRY z Pragmatic Programmer.
Podsumowanie: rzemiosło, nie ideologia
Inżynieria oprogramowania nie polega na maksymalizacji metryki „linijek bez powtórzeń”. Polega na minimalizacji długoterminowego kosztu zmiany. Czasem ten koszt jest niższy przy duplikacji, czasem przy abstrakcji — i to inżynier musi rozróżnić, nie linter.
Dwie zasady do zapamiętania, gdy następnym razem zobaczysz „podobny kod”:
- Rule of Three — traktuj kolejne wystąpienie jako okazję do sprawdzenia wzorca, nie automatyczny nakaz refaktoryzacji.
- Wrong abstraction kosztuje więcej niż duplikacja — bo abstrakcję trudniej cofnąć niż skopiować 30 linii.
Programiści, którzy to rozumieją, projektują systemy, które ewoluują. Programiści, którzy ścigają DRY jak dogmat, projektują systemy, które się usztywniają — aż dług abstrakcji wymusza przepisanie od zera.
Rozróżnienie między realną a pozorną duplikacją widać najwyraźniej, gdy czytasz i poznajesz cudzy kod — bo to wtedy oceniasz, które abstrakcje faktycznie niosą wartość. Ta sama trzeźwość wobec dogmatów przydaje się w debugowaniu, gdzie liczy się hipoteza, nie odruch.
Weryfikacja techniczna: definicja DRY w Pragmatic Programmer, Sandi Metz: The Wrong Abstraction.